気になるAIの話を、分かりやすく | 最新動向を、現場目線で
Cloudflareは2026年9月15日、「検索エンジンには巡回させたまま、AIの学習には使わせない」を選べる新しい設定(Disallow AI Training)を、全プランに追加しました[1]。Apple・Google・Microsoft が、この設定を尊重する、または期限を切って対応すると表明しています。
先に結論です。
- これまでは「検索も学習も許す」か「両方断る」かの二択でした。同じ1つのクローラーが検索と学習を兼ねているためです。今回それが分けられるようになりました
- 同じ日に「ブロック」の意味も変わりました。以前は検索を守るために検索兼用クローラーには適用されませんでしたが、今日からは適用されます。これから「ブロック」を選ぶと、検索からも消えます
- この設定が効くのは、通信を Cloudflare 経由にしているサイトだけです。CAGが確かめたところ、Cloudflare にドメインを預けている自社関連の4サイトは、いずれもこの条件を満たしていませんでした
この記事では、何が変わったか、なぜ必要だったか、今日どこまで伝わるか、自社サイトで効くかの確かめ方、の順に見ます。
01 何が変わったのか
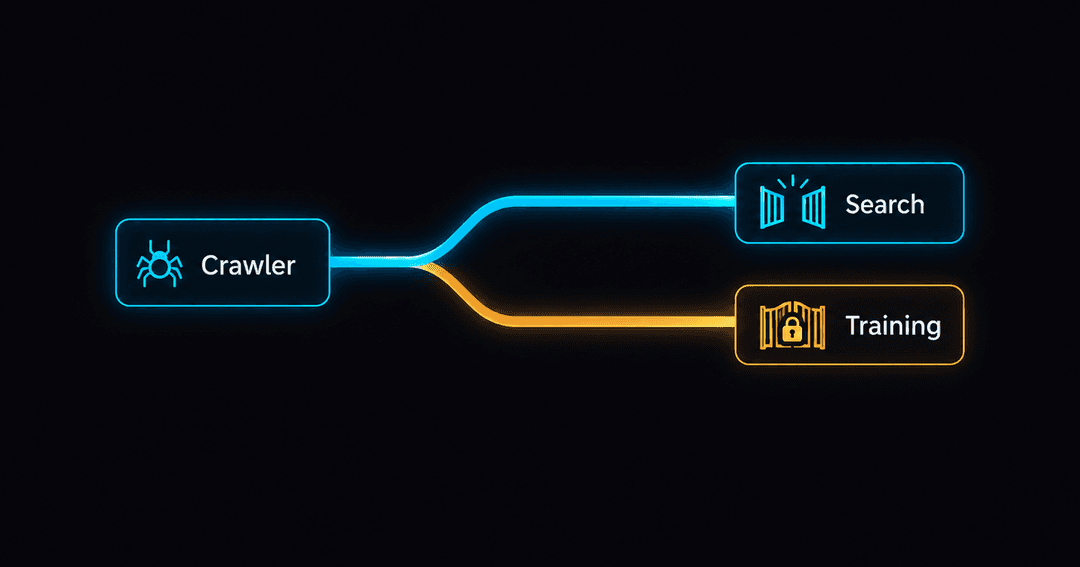
Cloudflare はクローラーを「振る舞い」で3つに分けています[1]。
| 振る舞い | 中身 |
|---|---|
| Search(検索) | 検索の索引を作るための巡回 |
| Training(学習) | モデルの学習・微調整のための巡回 |
| Agent(代理) | 人の指示で、その人の代わりにページを見にくるAI |
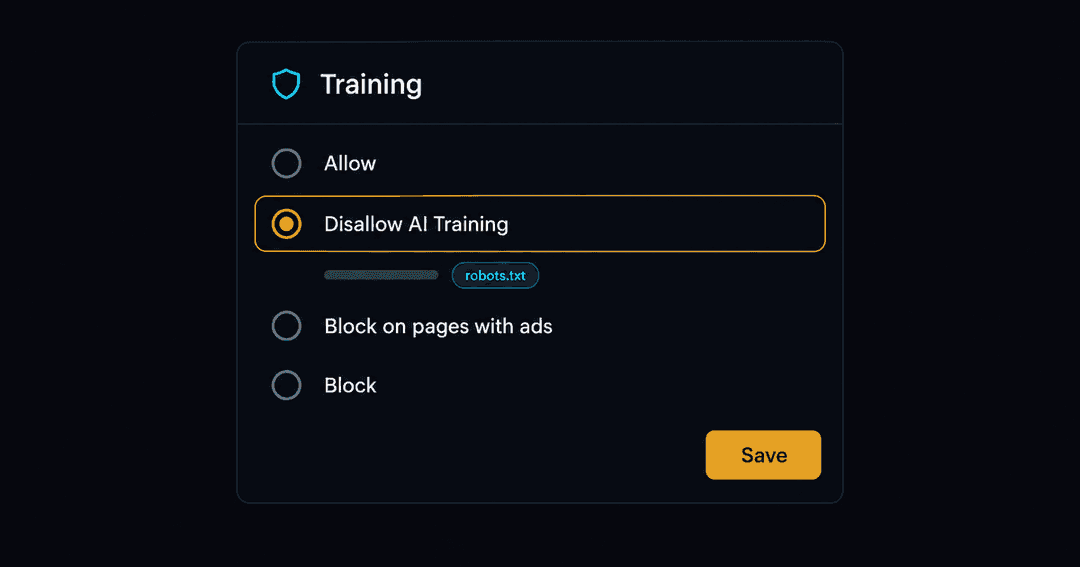
このうち Training に、新しく4つ目の選択肢が入りました。
| 設定 | 何が起きるか |
|---|---|
| Allow(許可) | すべて許可 |
| Disallow AI Training(新) | robots.txt に「学習お断り」を出す。検索兼用の対応済みクローラーは検索のために通す。Amazon・Anthropic・Meta・OpenAI の学習専用クローラーは遮断(検索には影響しない) |
| 広告のあるページだけブロック | 広告が出ていると判定されたページでのみ遮断 |
| Block(ブロック) | 検索兼用を含め、すべて遮断 |
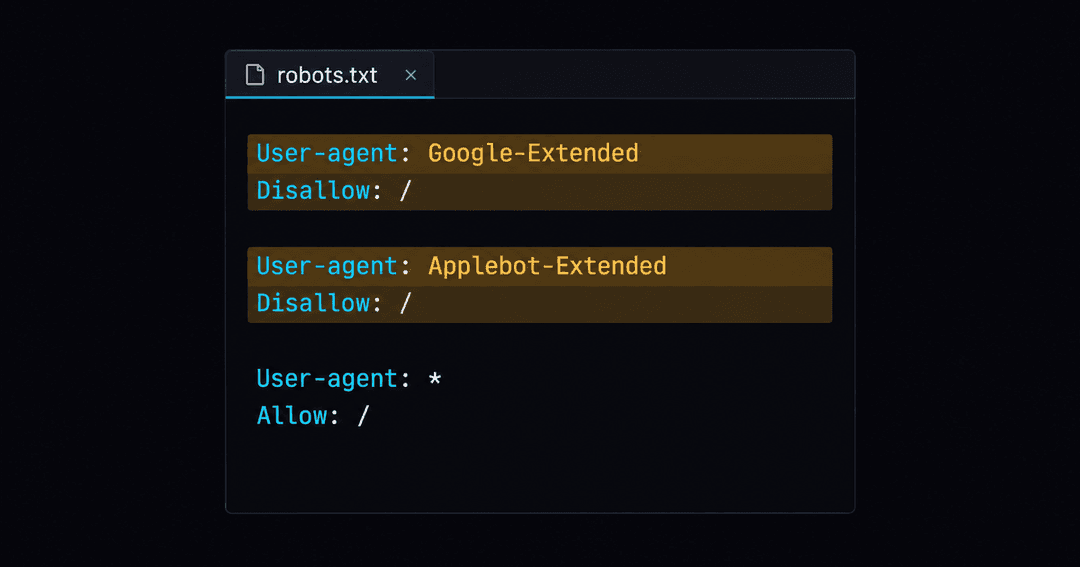
名前のとおり、この設定は robots.txt に Disallow を書き出す形で相手に伝えます。Cloudflare 側の用語では Bot Preference Sync という仕組みです。
02 なぜ「検索か学習か」の二択になっていたのか
原因は検索兼用クローラーです。1つのクローラーが検索と学習の両方をしているため、断ると検索からも消えます。
Cloudflare が挙げている数字が、サイト運営者の本音を表しています[1]。
- 検索ボットを遮断しているサイトは1%未満
- 学習を何らかの方法で遮断しているサイトは17%
「検索には出たい。でも学習には使われたくない」が多数派なのに、道具がなかった、ということです。Cloudflare は robots.txt だけでは足りない理由も書いています。誰が巡回しているかを特定できず、なぜ巡回しているかも判別できず、無視するクローラーを止められないからです。
あわせて Cloudflare は「Accountable(説明責任を果たす)」という区分を作り、条件を4つ挙げています。学習を断る手段、AI要約を断る手段、どのページが学習に使われたかのURL単位の可視化、そして学習を断っても検索順位に影響しないという保証です。Apple・Google・Microsoft がこの区分に該当するとしています。
03 同じ日に「ブロック」の意味が変わった
9月15日からの変更点です[1]。
- Block と「広告のあるページだけブロック」が、検索兼用クローラー(Applebot・Bingbot・Googlebot)にも適用される。つまり選ぶと検索にも影響する
- 「Block AI Bots」は廃止予定。Search/Training/Agent の細かい設定に置き換わる
- Managed Robots.txt も廃止予定で、Bot Preference Sync に移行する
既存の利用者は何もしなくてよいとされています。設定は自動で移行されます。
| これまでの設定 | 移行後(学習) | 検索への影響 |
|---|---|---|
| 「Block AI Bots」が無効 | Allow | なし |
| 「Block AI Bots」が有効 | Disallow AI Training | なし(検索は通る) |
| 細かい設定で学習を Block | Disallow AI Training | なし(検索は通る) |
危ないのは、これから設定する人です。「AIに使わせたくない」と考えて Block を選ぶと、Applebot・Bingbot・Googlebot も止まり、検索から消えます。学習だけ断りたいなら Disallow AI Training を選びます。
新しくドメインを追加するときは、広告収入の有無で推奨設定が変わります。広告で収益を得ているサイトには、学習は Disallow AI Training、代理AIは「広告のあるページはブロック」という、より制限の強い組み合わせが提示されます。
04 今日どこまで伝わるか ──Bing にはまだ届かない
設定したつもりでも、相手側の対応状況で結果が変わります。公式の説明を1社ずつ整理しました[1]。
| クローラー | 学習を断る方法 | 今日の状況 |
|---|---|---|
| Applebot(Apple) | robots.txt で Applebot-Extended を拒否 | 有効。URL単位の可視化は来年提供予定 |
| Googlebot(Google) | robots.txt で Google-Extended を拒否 | 有効。管理画面に生成系検索から除外するスイッチもある |
| Bingbot(Microsoft) | 現状は NOARCHIVE メタタグ、またはURLの除外ツール | robots.txt での「学習お断り」は未対応。2027年初頭を目標に構築中 |
つまり、Disallow AI Training を選んでも、今日の Bing には robots.txt 経由で学習拒否が伝わりません。Cloudflare もその旨を明記しています。以前の設定でも同じだったので悪化ではありませんが、「設定したから全部断れている」と思い込むと実態とずれます。
05 自社サイトで効くのか ──前提は「Cloudflare を通していること」
ここが実務では一番引っかかります。Cloudflare のドキュメントは、前提条件を3つ挙げています[2]。
- Cloudflare のアカウントを作る
- ドメインを Cloudflare に追加する
- 通信を Cloudflare 経由(プロキシ)にする
3つ目が抜けやすいところです。ネームサーバーだけ Cloudflare に預けて、通信は別のホスティングへ直接流している場合、Cloudflare はリクエストを見ていないので、クローラーを判別することも遮断することもできません。
CAGでも確かめました[3]。Cloudflare にネームサーバーを預けている自社関連の4ドメインを、公開情報だけで調べた結果です。
| サイト | ネームサーバー | 応答したサーバー | cf-ray ヘッダ |
|---|---|---|---|
| A(自社サイト) | Cloudflare | ホスティング側 | なし |
| B(LP基盤) | Cloudflare | ホスティング側 | なし |
| C(ポートフォリオ) | Cloudflare | ホスティング側 | なし |
| D(メディア) | Cloudflare | ホスティング側 | なし |
cf-ray は、Cloudflare を通ったときに付く応答ヘッダです。4件とも付いていませんでした。つまり、この4サイトでは今回の設定は効きません。確かめ方は1行です。
行が出れば Cloudflare 経由、出なければ経由していない
curl -sI https://example.com | grep -i cf-ray
06 次の論点は「AI要約」
Cloudflare は、学習とは別にAI要約を次の課題に挙げています[1]。要約は「学習に使われるか」ではなく、「人がサイトに来るかどうか」に直接効くからです。挙げられている数字は、どちらの方向にも読めます。
- 検索利用者の半数超がAI要約を読み、読んだ人は40%以上の割合でそこで検索を終える(訪問は減る)
- 一方、AI検索経由で来た人の成約率は、従来の検索経由の3倍から5倍超
Cloudflare は「どちらが良いとは決められない」としたうえで、来年初めを目標に「どれだけ自社の内容を要約に含めてよいか」を Cloudflare 側で一度に設定できるようにする、と書いています。今日の時点では、各社の窓口で個別に断る形です。
なお、Agent(人の代わりに見にくるAI)には、まだ Disallow にあたる設定がありません。業界標準(ai-prefs)の成熟を待つ、という説明です。
 関連記事 | 逆方向の話:AI側から見てよいサイトを絞るAIに「見ていいサイト」を指定できるようになった ──OpenAI・Anthropic・AWSの3社を比べて分かった、拒否のされ方の違い
→
07 使う前のチェックリスト
- 自社サイトが Cloudflare を経由しているか、
cf-rayヘッダで確かめた - 「AIに使わせたくない」で Block を選んでいないか確認した(検索も止まる)
- 学習だけ断りたいので Disallow AI Training を選んだ
- Bing には今日は robots.txt 経由で伝わらないことを把握した(必要なら NOARCHIVE を併用)
- 広告収入があるサイトは、推奨される設定が別であることを確認した
- AI要約の扱いは、来年の設定追加を待つか、各社の窓口で個別に断るかを決めた
08 まとめ
- 「検索には出したい、学習には使われたくない」が、設定1つで表明できるようになった。全プランで使える
- 同じ日に「ブロック」の意味が変わった。これから選ぶ人は、検索まで止まることを承知で選ぶ必要がある
- 設定が効くのは Cloudflare を通しているサイトだけ。CAGの4ドメインはいずれも通しておらず、対象外だった
設定を足す前に、その設定が自分のサイトまで届いているかを確かめる。届いていない設定は、選んでも何も起きません。
自社サイトのAI対応を見直したい方へ
電脳技巧集団(AI職人ギルド)は、AI駆動でWebサイトと業務システムをつくっています。「どこまでAIに使わせるか」の設計から相談できます。お問い合わせはこちら
出典・注記
- Cloudflare「Have it both ways: stay discoverable in search while disallowing AI training」2026年9月15日。https://blog.cloudflare.com/accountable-mixed-use-ai-crawlers/ 新設定、移行の扱い、Accountable の要件、各社クローラーの状況、AI要約の数字。
- Cloudflare Docs「AI Crawl Control - Get started」(2026年9月16日閲覧)。https://developers.cloudflare.com/ai-crawl-control/get-started/ 前提条件(Cloudflare 経由でのプロキシ)。
- CAG実測(2026年9月16日)。Cloudflare にネームサーバーを預けている自社関連の4ドメインについて、
digでネームサーバーとIPを、curl -sIで応答ヘッダを取得。4件ともcf-rayヘッダなし。設定画面は操作していない。
実測以外の数値・仕様は Cloudflare の公式発表とドキュメントに基づくもので、CAG自身が検証したものではありません。