気になるAIツールを、分かりやすく
2026年9月22日、OpenAIがGPT-6 SolとGPT-6 Lunaを公開しました。同じ日、AnthropicもClaude Opus 5.5を公開しています[1][2]。GPT-6 Solの単価は、入力も出力もOpus 5.5のちょうど半分です。
前回と同じ修正課題を、各社のAIエージェント(Codex と Claude Code)に解かせて比べました。1回あたりの費用はSolがOpus 5.5より約4割安く、かかった時間は約2.3倍でした。Lunaの費用はOpus 5.5の約40分の1でしたが、直した量もいちばん少なくなりました。
- 何が出たか(価格・ChatGPTで使える場所・既定の設定)
- 同じ日に出たのに、互いの比較表に互いが載っていない
- 単価を並べる。キャッシュ読み込みは同じ値段
- 実測:同じ課題を各社の道具で
- 半額なのに4割安にとどまった理由
- Lunaの「40分の1」の中身
- 選ぶ前に確かめること
01 何が出たか。Solは単価半額、既定の深さはmedium
GPT-6はAstra・Sol・Lunaの3段構成です。今月初めに最上位のAstraが出ており、今回はその下の2つです。Solは複雑なコーディングとエージェント向け、Lunaは量の多い定型作業向けと位置づけられています[1][3]。
| 項目 | GPT-6 Sol | GPT-6 Luna | Claude Opus 5.5(参考) |
|---|---|---|---|
| 入力(100万トークンあたり) | $2 | $0.10 | $4 |
| 出力(同) | $10 | $0.50 | $20 |
| 前世代(GPT-5.6)からの値下げ | 50% | 入力50%・出力58% | 入力・出力とも20% |
| effortの既定値 | medium | medium | medium |
| 一度に扱える量 | 105万トークン | 105万トークン | 100万トークン |
| 長い入力の割増 | 27.2万トークン超でリクエスト全体が入力2倍・出力1.5倍 | 同左 | なし(100万まで同じ単価) |
LunaのGPT-5.6からの値下げ幅は、入力が$0.20→$0.10で50%、出力が$1.20→$0.50で58%です。発表の表は2つとも「50% cheaper」と書いていますが、Lunaの出力だけは半分より下がっています[1]。
ChatGPTでの扱いには注意が要ります。使えるのはWorkとCodexだけで、ふだんの会話(Chat)ではまだ選べません。Plus・Pro・Business・Enterprise・Eduが対象で、無料プランとGoはデスクトップアプリでLunaだけ使えます。Enterpriseは管理者が新しいモデルを有効にするまで使えません[1][4]。
02 同じ日に出たのに、互いの比較表に互いがいない
OpenAIの発表は、SolをClaude Opus 5やFable 5.1と比べています。AnthropicのOpus 5.5の発表は、GPT-6 AstraとGPT-5.6 Solと比べています。どちらの表にも、相手が同じ日に出した新モデルは載っていません[1][2]。
理由はOpenAIの注記から読み取れます。「競合モデルの数値は公開されているレポートから取った。Fable 5.1の数値が無いときはFable 5の数値を載せた」とあります[1]。同じ日に出たモデルには公開レポートがまだ無いので、載せようがありません。
ただ、つなげられる評価が1つあります。業務アプリをまたぐワークフローを試すZapierのAutomationBenchです。両社の表にOpus 5が26.9%、Fable 5.1が31.4%と同じ値で載っているため、同じ公開リーダーボードから引いていると分かります。2つの表を1本に並べるとこうなります。
この並びではOpus 5.5がSolを6.8ポイント上回ります。ただし出どころは別々です。Opus 5.5の40.0%は、Zapierが早期アクセス中に測った値です。安全策が作動した課題は失敗として数えており、Anthropicは「実際より低く出ている」と注記しています[2]。Solの33.2%はOpenAIの発表値で、1課題あたり$0.27でした。Opus 5.5の1課題あたりの費用は公表されていません。
逆に、つなげない方がよい例もあります。画面操作のOSWorld 2.0では、Opus 5の値がOpenAIの表では60.3%(mediumで、オフライン版のセットを使ったもの)、Anthropicの表では74.0%でした。同じモデルでも、測った条件が違えば14ポイント近く変わります。2社の表を混ぜるときは、共通して載っているモデルの値が一致するかを先に確かめてください。
 関連記事 | 同じ日に出たもう一方Claude Opus 5.5とは ──「Opus 5より40%安い」を15回の実測で確かめ、乗り換えで変わることを整理
→
03 単価を並べる。キャッシュ読み込みは同じ値段
入力と出力はSolがちょうど半分です。ところが、一度読み込ませた内容を使い回すキャッシュの読み込みは、どちらも100万トークンあたり$0.20で同じでした[3][5]。OpenAIは入力の1割、Anthropicは入力の5%に設定していて、元の単価が倍違うので結果が同じ値になります。
キャッシュの仕組みも違います。OpenAIのキャッシュは最後に使ってから30分残ります。Anthropicは5分か1時間を選び、1時間を選ぶと書き込み単価が入力の2倍(Opus 5.5なら$8)になります[5][6]。
もう1つ、長い入力の扱いが逆です。Solは入力が27.2万トークンを超えると、そのリクエスト全体で入力とキャッシュが2倍、出力が1.5倍になります[3]。すると入力単価は$4でOpus 5.5と同じ、キャッシュ読み込みは$0.40でOpus 5.5の2倍です。Opus 5.5は100万トークンまで同じ単価です[5]。大きなコードベースや長い資料を丸ごと渡す使い方では、「半額」がそのまま当てはまりません。
04 実測:同じ課題を各社の道具で
課題は前回と同じ、月末最終日の利用が集計から漏れる小さなバグの修正です。原因を特定して直し、境界のテストを足し、テストが通ることを確かめて報告するよう頼みました。GPT-6はOpenAIのCodex、Opus 5.5はAnthropicのClaude Codeで、どちらも非対話モードで各3回ずつ実行しています[7]。
正解かどうかは、モデルに見せていない同じ別テストで判定しました。今回の15回も前回の9回も、すべて正解でした。
| 条件 | 1回あたりの費用 | かかった時間 | 出力トークン | 足したテスト |
|---|---|---|---|---|
| Opus 5.5 / low | $0.102 | 13.7秒 | 985 | テスト2本 |
| Opus 5.5 / medium(既定) | $0.156 | 23.7秒 | 2,103 | テスト2〜3本 |
| Opus 5.5 / high | $0.163 | 25.0秒 | 2,311 | テスト2〜3本 |
| GPT-6 Sol / low | $0.068 | 29.7秒 | 707 | assert 1行(3回中2回) |
| GPT-6 Sol / medium(既定) | $0.092 | 54.3秒 | 1,720 | テスト1〜2本 |
| GPT-6 Sol / high | $0.101 | 62.0秒 | 1,889 | テスト1〜3本 |
| GPT-6 Luna / medium(既定) | $0.004 | 31.7秒 | 730 | assert 1行 |
| GPT-6 Luna / high | $0.004 | 45.0秒 | 1,310 | assert 1行 |
既定の medium どうしで比べると、SolはOpus 5.5より41.2%安く、2.29倍の時間がかかりました。high どうしでは38.2%安く、2.48倍の時間でした。単価は半分なのに、実費は半分になっていません。
注意点が2つあります。1つ目に、比べているのはモデル単体ではなく「モデル+各社の道具」です。CodexとClaude Codeでは、AIに渡す指示文も、ファイルの読み方も、テストの回し方も違います。2つ目に、Codexはキャッシュの書き込みを0と報告しました。キャッシュされなかった入力を通常の入力単価で計算していますが、仮にすべてが書き込み単価(1.25倍)だったとしても、Solの割安さは medium で34.6%にとどまります。
05 半額なのに4割安にとどまった理由
費用の中身を分けると、理由が見えます。medium の1回分の内訳です。
| 内訳(medium・1回あたり) | GPT-6 Sol(Codex) | Opus 5.5(Claude Code) |
|---|---|---|
| 読み込んだ入力の合計 | 約18.9万トークン | 約17.4万トークン |
| キャッシュされなかった入力 | 約2.1万トークン → $0.041 | ほぼ0 |
| キャッシュ書き込み | 報告なし | 約1.0万トークン → $0.081(1時間の単価) |
| キャッシュ読み込み | 約16.8万トークン → $0.034 | 約16.4万トークン → $0.033 |
| 出力 | 1,720トークン → $0.017 | 2,103トークン → $0.042 |
| 合計 | $0.092 | $0.156 |
Opus 5.5の費用の半分以上はキャッシュ書き込みでした。Claude Codeはキャッシュを1時間残す設定で書き込むため、入力の2倍の単価がかかります。Solの側は、キャッシュされなかった入力が費用の約45%を占めました。キャッシュ読み込みはどちらも$0.03台でほぼ同じで、03章の「読み込みは同じ値段」がそのまま出ています。
時間の差は、主にやり取りの回数から来ています。Solは medium で1回あたり4〜7回コマンドを実行し、high では7〜9回でした。読み込んだ入力の合計も、effortを上げるほど増えています(low 約14.2万 → high 約21.2万トークン)。
06 Lunaの「40分の1」の中身
Lunaの費用は1回$0.004で、Opus 5.5の既定の約40分の1でした。修正は3回とも正解しています。
ただし、直した量は最小でした。Lunaは6回とも、既存のテストに境界を確かめる1行を足しただけです。Opus 5.5はテストを2〜3本、前世代のOpus 5は毎回4本足していました。Solの low も3回中2回は1行だけでした。
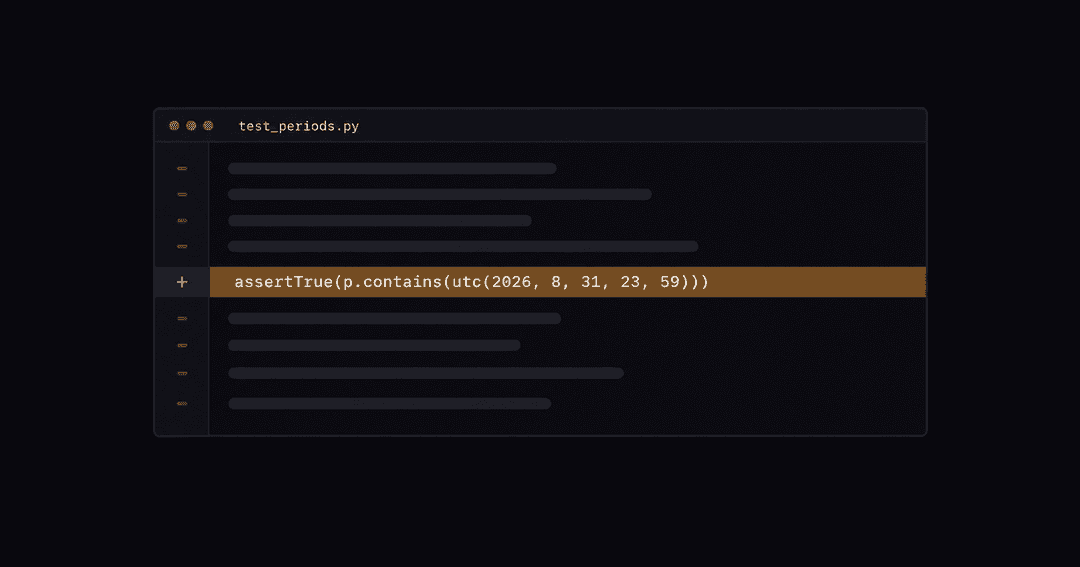
指示どおり「境界を確かめるテスト」ではあり、間違いでもありません。1行で足りる作業なら、Lunaは費用の面で抜きん出ています(時間はOpus 5.5の既定より長くかかりました)。一方、「将来の変更から守るテストを厚くしておく」ことまで期待するなら、上位のモデルか、プロンプトで本数を指定する必要があります。発表も、Lunaを「量の多い、焦点の絞られた作業」向けとしています[1]。
 関連記事 | GPT-6 の最上位モデルGPT-6 Astra とは何か ──画面を見て操作するAIの実力と、今日から使える条件を解説
→
07 選ぶ前に確かめること
- 「半額」を実費に置き換えて測る。今回の課題では、単価半額のSolが実費で4割安でした。キャッシュの使われ方で差は縮みます
- 待ち時間も費用として見る。SolはOpus 5.5の2.3倍かかりました。人が結果を待つ作業か、夜間にまとめて流す作業かで評価が変わります
- 入力が27.2万トークンを超える使い方をしているか確かめる。超えるとSolの入力単価はOpus 5.5と同じになります
- Lunaには、作業の量を指示で決めて渡す。放っておくと最小限で終わります
- ChatGPTで使いたいなら、WorkかCodexから選ぶ。Chatにはまだ出ていません。Enterpriseは管理者の有効化が先です
- 2社の比較表を自分でつなぐときは、共通のモデルの値が一致するかを見る。一致しなければ、測った条件が違います
| GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|
| 単価(入力/出力) | $2 / $10(半分) | $4 / $20 |
| キャッシュ読み込み | $0.20 | $0.20(同じ) |
| 27.2万トークン超 | 入力2倍・出力1.5倍 | 割増なし |
| 今回の実費(medium) | $0.092(41%安い) | $0.156 |
| 今回の時間(medium) | 54.3秒(2.3倍) | 23.7秒 |
| AutomationBench | 33.2%(xhigh) | 40.0%(早期アクセス時) |
同じ日に出た2つのモデルは、どちらも発表の比較表に相手が載っていませんでした。自分たちの課題で測ってみると、単価の差は半分でも、実費と時間の差は別の形で現れました。
単価の比率は、実費と時間の比率ではない。
どのモデルをどの設定で使うか、相談したい方へ
電脳技巧集団(AI職人ギルド)は、AI駆動で業務システムをつくっています。自社の作業でモデルを測って選ぶところから相談できます。お問い合わせはこちら
出典・注記
- OpenAI「Introducing GPT-6 Sol and Luna」2026年9月22日。https://openai.com/index/introducing-gpt-6-sol-and-luna/
- Anthropic「Introducing Claude Opus 5.5」2026年9月22日。https://www.anthropic.com/claude-opus-5-5
- OpenAI API Docs「GPT-6 Sol」「GPT-6 Luna」「Using GPT-6」(2026年9月24日閲覧)。https://developers.openai.com/api/docs/models/gpt-6-sol / https://developers.openai.com/api/docs/guides/latest-model/gpt-6-astra
- OpenAI Codex Changelog 2026年9月22日「GPT-6 Sol and Luna in Codex and ChatGPT Work」(2026年9月24日閲覧)。https://developers.openai.com/codex/changelog
- OpenAI API Docs「Pricing」、Claude Platform Docs「Pricing」(いずれも2026年9月24日閲覧)。https://developers.openai.com/api/docs/pricing / https://platform.claude.com/docs/en/about-claude/pricing
- OpenAI API Docs「Prompt caching」(2026年9月24日閲覧)。https://developers.openai.com/api/docs/guides/prompt-caching
- CAGによる実測。GPT-6は2026年9月24日に、ChatGPTアプリ同梱のCodex CLI(0.155.0-alpha)の非対話モードで、利用者設定とルールを読み込まない状態にして、モデルとeffortだけを変えて各3回、計15回実行しました。費用は報告されたトークン数に、OpenAIの標準料金(27.2万トークン以下)を掛けた定価換算で、15回の合計は約0.81ドルです。Opus 5.5は2026年9月23日の同じ課題の実測(Claude Code 2.1.280)で、各3回。課題はテストを含めて約70行のPythonコード1種類で、長時間の作業や xhigh・max は測っていません。ベンチマークの数値は両社の発表からの引用で、CAGの検証ではありません。