気になるAIツールを、分かりやすく
2026年9月21日、xAIが新モデルGrok 4.7を公開しました。同じ日に、GitHub Copilotでも選べるようになりました[1][2]。
効いてくるのは日付の一致ではありません。Copilot BusinessとCopilot Enterpriseでは、管理者が何もしなければこのモデルが自動的に有効になります[3]。8月26日に正式提供されたモデルポリシーが9月1日までに行き渡り、その最初の大きな実例が今回でした。
- 何が起きたか(同じ日に、どのプランで、どこで使えるようになったか)
- 「何もしなければ有効」の仕組みと、既定で有効にならない4類型
- 増えるのは選択肢だけで、自動選択の対象ではない
- 料金は据え置き。ただし20万トークンを超えると単価が2倍
CAGは対象プランの組織アカウントを持っていないため、画面での確認はしていません。公式ドキュメントとベンダー発表の突合、および公開されている表の計数だけで書いています[6]。
01 同じ日に、2つの発表があった
xAIの発表(2026年9月21日)は、Grok 4.7を「コーディングと知識労働のための最も高性能なモデル」と紹介しています。本文には「Grok 4.6と同じ価格・同じ速度で提供する」とあります[2]。
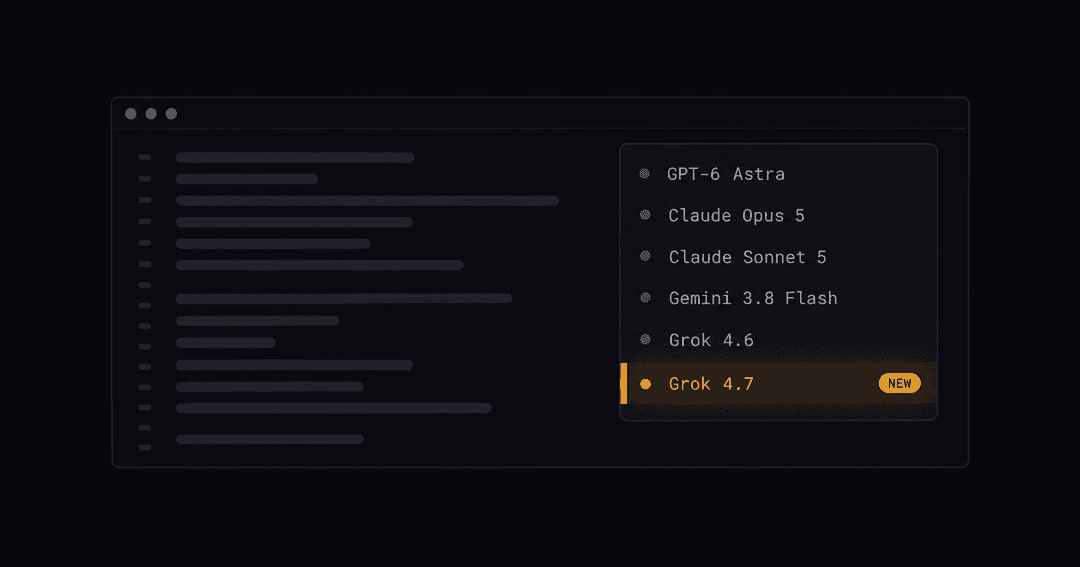
GitHubのchangelog(同日)はこう書いています——CopilotのPro・Pro+・Max・Business・Enterpriseで選べるようになり、場所はVisual Studio Code、Visual Studio、Copilot CLI、Copilotのクラウドエージェント、GitHub Copilotアプリ、JetBrains、Xcode、Eclipse[1]。
xAI側の「提供先」の記述には、Cursor・Grok Build・Grok API・サードパーティのコーディングハーネス・モデルルーター・クラウドが並んでいますが、GitHub Copilotは名指しされていません[2]。
02 「何もしなければ有効」は、8月に決まっていた
Copilot Business / Enterpriseには「Default availability for released models(公開済みモデルの既定の可用性)」というポリシーがあります。公式ドキュメントの説明はこうです[3]。
明示的に設定していないモデルに既定が適用される。組織の設定画面では「Delegate to Default Policy」と表示される。新しいモデルが公開されると、明示的に設定するまでその既定を引き継ぐ。
GitHub Docs「About default availability of Copilot models」
changelogも同じことを、今回のモデルについて書いています——「管理者がグローバルの既定をオフにしているか、このモデルを明示的に無効にしていない限り、新しいモデルは自動的に有効になる」[1]。
前回書いたのは「管理者が何もしなかったとき、設定はどちらに倒れるのか」という制度の話でした。今回はその最初の大きな実例です。
 関連記事 | この既定が決まった日社員のAI利用を、会社はどこまで見られるか ──8月26日に重なった3つの統制機能と、放置したときに倒れる向き
→
03 既定で有効にならないのは4類型。そこにAnthropicのモデルがある
同じドキュメントに、このポリシーの対象外=「Default availability」の設定にかかわらず既定で無効になるものが列挙されています[3]。
| 既定で有効にならないもの | 具体例 |
|---|---|
| 正式提供前のモデル | Pre-GA のもの |
| オープンウェイトのモデル | DeepSeek、Kimi K2.7 Code、Kimi K3 |
| データ保持契約の対象外のモデル | Claude Fable 5、Claude Fable 5.1 |
| データ所在地・FedRAMPの制限に沿わないモデル | その制限をかけている企業で |
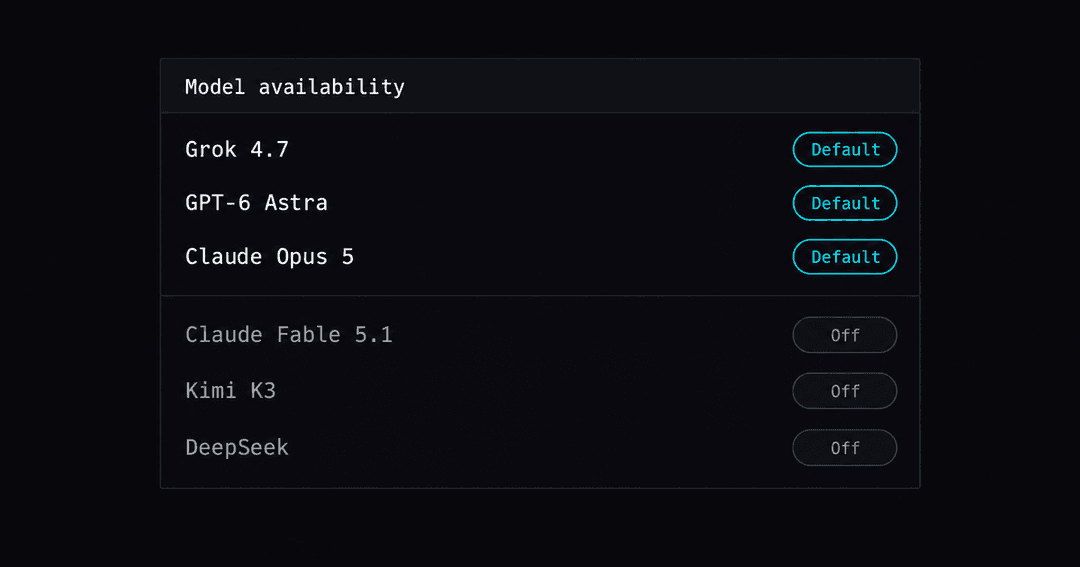
Grok 4.7は正式提供(GA)で、この4類型のどれにも当てはまりません。だから既定で有効になります。一方、AnthropicのClaude Fable 5と5.1は「GitHubのデータ保持契約の対象外」という理由で既定オフです。
ベンダーによって既定が逆を向いています。理由は性能でも人気でもなく、GitHubとそのベンダーの間にデータ保持の取り決めがあるかどうかです。「新しいモデルが勝手に増えて困る」と言うとき、実際に増えるのは取り決めが済んでいるベンダーのモデルだけ、ということになります。
04 増えるのは「選択肢」で、自動で使われるわけではない
公式の表を数えて分かったことがあります。Copilotには、利用者がモデルを選ばなくても適切なものを選ぶAuto model selection(自動モデル選択)があります。その対象モデルを数えると14個で、Grokは4.5・4.6・4.7のいずれも入っていませんでした[5]。
管理者が何もしなくても起きるのは「利用者のモデル選択リストにGrok 4.7が1行増える」までで、選ばなければ使われません。ここを混同すると、打つ手の大きさを間違えます(ポリシーを止めるのか、社内に周知するだけでよいのか)。
05 値段は据え置き。ただし20万トークンを超えると2倍
GitHubの料金表からGrokの2世代を抜き出すと、こうなっています(100万トークンあたり。1 AIクレジット=0.01米ドル)[5]。
| モデル | 区分 | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|---|
| Grok 4.6 | 20万トークン以下 | $2.00 | $0.50 | $6.00 |
| Grok 4.6 | 20万トークン超 | $4.00 | $1.00 | $12.00 |
| Grok 4.7 | 20万トークン以下 | $2.00 | $0.50 | $6.00 |
| Grok 4.7 | 20万トークン超 | $4.00 | $1.00 | $12.00 |
世代が上がっても単価は1セントも変わっていません(xAIの「Grok 4.6と同じ価格」という記述と一致します)。一方で、20万トークンを超えた瞬間に入力・キャッシュ・出力のすべてがちょうど2倍になります。大きなコードベースを丸ごと渡す使い方では、ここが効きます。
数え方も押さえておきます。Copilotの有料プランにはAIクレジットの枠が含まれ、BusinessとEnterpriseは利用者ごとの枠が請求単位でプールされます。枠を超えた分が、上の単価で従量課金されます[5]。
06 xAI自身のベンチ表を、1行ずつ読む
xAIの発表には、Grok 4.7・Grok 4.6・GPT-5.6 Sol・Claude Fable 5.1を並べた表が載っています。7つのベンチマークを1行ずつ見ると、Grok 4.7が首位なのは2つでした[2]。
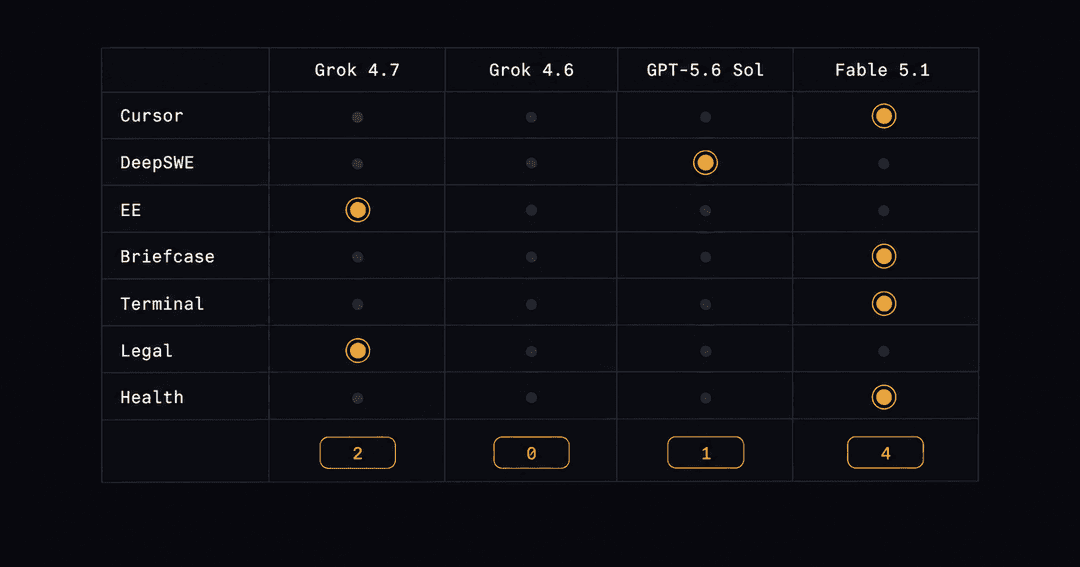
| 項目 | Grok 4.7 (xHigh) | Grok 4.6 (High) | GPT-5.6 Sol (Max) | Fable 5.1 (Max) |
|---|---|---|---|---|
| 入力単価($/100万) | $2 | $2 | $4 | $10 |
| 出力単価($/100万) | $6 | $6 | $20 | $50 |
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%※ | 65.2% | 72.7% | 70.0% |
| EEBench(電気工学) | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey 法務エージェント | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
読むときの注意が3つあります。
- 首位は7つ中2つ(EEBenchと法務)。Fable 5.1が4つ、GPT-5.6 Solが1つです。xAI自身も本文では「最強」ではなく「価格性能で最前線」という書き方をしています
- 比較している設定が違います。Grok 4.7はxHigh、他社はMax、Grok 4.6はHigh。しかもDeepSWEの71.0%には「※ high effort」と注記があり、この1つだけ列の見出しと違う設定です
- 単価差が前提にあります。入力はFable 5.1の5分の1、出力は8分の1以下。「同じ土俵で勝っている」ではなく「この値段でここまで」という主張だと読むのが正確です
見出しの「最も高性能」は、自社の前世代との比較としては表のとおり全項目で成り立ちます。他社との比較に広げると成り立ちません。
07 管理者が今日できること
- 自社がBusinessかEnterpriseなら、「Default availability for released models」が有効かどうかを見る。有効なら、GAのモデルは設定しない限り増え続けます
- 増やしたくないなら、止め方は2つ。ポリシー自体を無効にするか、モデルを1つずつ明示的に無効にする。厳しい要件のある組織だけポリシーを切ることもできます[3]
- 「増えた=使われた」ではないと社内に伝える。自動選択の対象ではないので、選ばなければ使われません
- 20万トークン超で単価が2倍になることを、大きなリポジトリを扱うチームに伝える
| 何もしなかった場合 | ポリシーを切った場合 | |
|---|---|---|
| 新しいGAモデル | 公開のたびに自動で増える | 増えない(都度、明示的に有効化) |
| Claude Fable 5 / 5.1 | 増えない(契約対象外で既定オフ) | 増えない |
| オープンウェイト(DeepSeek・Kimi) | 増えない(既定オフ) | 増えない |
| 利用者の操作 | 選択肢が1つ増えるだけ | 変わらない |
| 管理の手間 | あとから気づく | 公開のたびに判断が要る |
モデルが増えた日に、増えたことを知らせてくれる人はいない。
社内のAI利用のルールづくりを相談したい方へ
電脳技巧集団(AI職人ギルド)は、AI駆動で業務システムをつくっています。どのツールをどこまで開き、どこで線を引くかの設計から相談できます。お問い合わせはこちら
出典・注記
- GitHub Changelog「Grok 4.7 is now available in GitHub Copilot」2026年9月21日。https://github.blog/changelog/2026-09-21-grok-4-7-is-now-available-in-github-copilot/
- SpaceXAI(xAI)「Introducing Grok 4.7」2026年9月21日。https://x.ai/news/grok-4-7
- GitHub Docs「About default availability of Copilot models」(2026年9月22日閲覧)。https://docs.github.com/en/copilot/concepts/models/default-availability
- GitHub Changelog「Global model policy generally available」2026年8月26日。https://github.blog/changelog/2026-08-26-global-model-policy-generally-available/
- GitHub Docs「Supported AI models」「Models and pricing」(2026年9月22日閲覧)。https://docs.github.com/en/copilot/reference/ai-models/supported-models / https://docs.github.com/en/copilot/reference/copilot-billing/models-and-pricing
- 本記事はCAGの実機検証ではありません(対象プランの組織アカウントが必要なため)。2026年9月22日時点の公式ドキュメントとベンダー発表の記述、および公開されている表の計数に基づきます。自動選択の対象14モデルと、ベンチ7項目の首位数(Grok 4.7が2、Fable 5.1が4、GPT-5.6 Solが1)は、公式ページの表をCAGが数えたものです。