AI学習に自社サイトを使ってほしくない。その意思を、AI企業ごとに設定し直す手間が減りそうです。2026年10月30日、OpenAI、Google、Microsoftが、robots.txtに書く共通のAI学習設定への対応方針を発表しました。Anthropicも同日、担当者が実装に着手したと明らかにしています。[1][2][3][4]
ただし、4社とも一斉に対応を完了したわけではありません。また、Googleでは学習への利用を断る設定が、Geminiアプリの回答で根拠として使われるかどうかにも関わります。検索への掲載、学習への利用、AI回答への利用を分けて読むと、自社サイトで判断することが見えてきます。
本記事は2026年11月1日時点の公式発表・公式資料・IETF草案に基づく解説です。各社のクローラーが新設定を適用する動作を、CAGが実測した記事ではありません。
01 AI学習を断る共通設定、何が変わるのか
robots.txtは、サイト運営者が自動巡回プログラムに向けて希望を伝えるため、サイトに置くテキストファイルです。自動巡回プログラムは「クローラー」と呼ばれ、検索用の情報収集などに使われます。
これまでは、AI企業ごとのクローラー名や専用の設定名を調べ、別々に指定する必要がありました。今回の共通設定は、対応する複数の企業へ、同じ書き方でAI学習への意思を伝えるためのものです。OpenAIは、サイト側の設定管理の負担を減らす取り組みと説明しています。[1]
共通の名前は __usage_ai-training。ここで指定するのは、コンテンツを生成AIモデルの学習に使ってよいかという希望です。単にページを取りに来る通信を遮断する設定とは役割が違います。[5]
対応時期には差があります。
| 会社 | 2026年11月1日時点の対応予定・状況 | 一次情報の位置づけ |
|---|---|---|
| OpenAI | 数か月以内の実装を目指す | 10月30日の公式発表 |
| 2027年初めの対応を予定 | 発表ブログは「2027年」、クローラー資料は「early 2027」と記載 | |
| Microsoft | 2027年2月1日から、クロール時に新設定を適用 | 10月30日のBing公式発表 |
| Anthropic | 実装に着手。提供開始日は未公表 | 草案の著者・Anthropic所属のKevin Kelley氏によるIETFへの投稿 |
OpenAIとAnthropicは、既存のクローラー向け設定を置き換えるものではないと説明しています。共通設定が発表されたことを理由に、現在使っている個別設定をすぐ削除する必要はありません。[1][4]
02 robots.txtにはどう書くのか
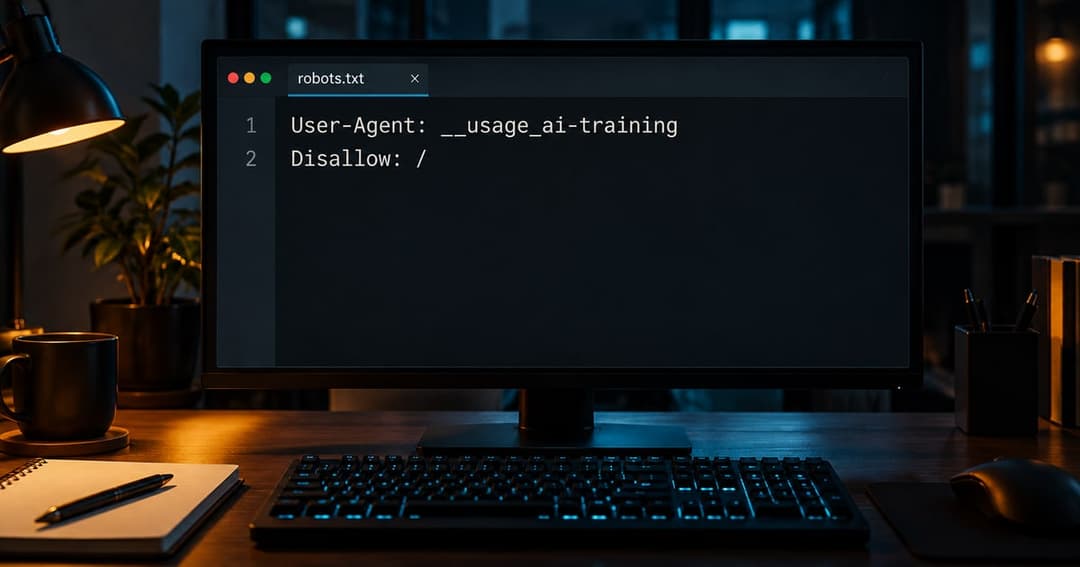
サイト全体についてAI学習への利用を断る例は、次の2行です。[5]
User-Agent: __usage_ai-training
Disallow: /
User-Agent の行は「何に対する設定か」を示し、Disallow: / はサイト全体について利用を断る意思を示します。名前を1行書くだけで、学習を拒否したことにはなりません。
一部だけ利用を認めたい場合も、既存のrobots.txtと同じ書き方を使えます。草案では、サイト全体の学習利用を断りつつ、広報素材のフォルダーを例外として認める例が示されています。[5]
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
この例では、/press-kit/ の中は学習利用を認める意思表示になります。自社サイトに実在するパスと、公開方針に合わせて決める設定です。
一方、User-Agent: * という全クローラー向けの指定は、この共通設定への意思表示としては扱われません。検索用クローラーの巡回を制限する規則と、学習への利用方針は、それぞれの目的に合わせて管理します。[5]
仕組みの根拠は、IETFというインターネット技術の標準化団体に提出された個人草案です。正式なIETF標準として確定した段階ではありません。対応を表明した企業が尊重する任意の意思表示であり、これだけですべての収集者のアクセスを強制的に止めるものではありません。[5]
03 Google検索とGeminiへの影響は分けて考える
Googleで確認したいのは、Google-Extended との関係です。これは、Googleが取得したコンテンツについて、将来のGeminiモデルの学習や、Geminiアプリなどの回答を支える情報への利用を管理するための名前です。[6]
AIが回答を作る際に、ウェブの情報を参照して事実性や関連性を補う仕組みを「グラウンディング」と呼びます。学習が将来のモデルを作る工程なのに対し、こちらは回答を作るときに情報を渡す工程です。
Googleは、新しい共通設定で学習利用を断り、個別のGoogle-Extended指定がない場合、Google-Extendedを拒否したのと同様に扱う予定です。Google-Extendedは、学習に加え、GeminiアプリとVertex AIのGoogle検索によるグラウンディングも対象にしています。[2][6]
| 利用される場面 | Google-Extendedを拒否した場合 |
|---|---|
| Google検索への掲載 | 掲載への影響はない |
| Google検索の順位 | 順位を決める要因として使われない |
| 将来のGeminiモデルの学習 | この設定で管理される学習利用を断る |
| Geminiアプリの回答の根拠としての利用 | この設定で管理されるグラウンディング利用を断る |
| Vertex AIのGoogle検索によるグラウンディング | この設定で管理される利用を断る |
つまり、「検索順位には影響しない」と「Geminiの回答からの流入にも影響しない」は同じ意味ではありません。Googleは、Google-Extendedを明示的に許可したサイトは、Geminiアプリの回答に登場し、グラウンディング経由でクリックを受ける対象になり得ると説明しています。掲載や流入が保証されるわけではありません。[2][6]
また、個別のGoogle-Extended指定がある場合は、そちらが優先されます。たとえば共通設定では断り、Google-Extendedでは許可すると、Googleについては許可の指定が優先されます。ただし、Google-Extendedは学習とグラウンディングをまとめて管理するため、この組み合わせは「Googleの学習は断り、Geminiでの参照だけ許可する」設定にはなりません。[2][6]
自社の解説ページや商品情報を、AI回答を通じても見つけてもらいたいのか。それとも、この範囲の利用を断る方針なのか。検索の順位だけで決めず、Geminiアプリなどでの扱いも含めて選ぶことになります。
04 サイト運営者が今確認すること
まず、自社サイトの希望を「学習への利用」「AI回答の根拠としての利用」「検索への掲載」に分けて整理します。そのうえで、現在のrobots.txtにある個別指定と、新しい共通設定の関係を確認します。
Microsoftは、学習とグラウンディングを独立した希望として扱うと説明しています。学習を断りながら、AI回答の根拠としての利用は認める選択も可能です。同じ共通設定に対応しても、各社の周辺設定まで同じになるわけではありません。[3]
既存のMicrosoft向け設定を使っているサイトには、移行の確認も必要です。Microsoftは、2027年3月1日以降、NoArchive と NoCache を学習・グラウンディングへの意思表示として読まなくなると案内しています。該当する運営者は、Bingの公式手順で新しいページ単位の設定や移行措置を確認してください。[3]
| 確認すること | 自社サイトで決める内容 |
|---|---|
| 学習への利用 | 全体で認めるか、断るか、一部のパスを例外にするか |
| AI回答への利用 | 根拠や引用として紹介される対象でありたいか |
| 既存の個別設定 | Google-Extendedなどに、共通設定と異なる指定があるか |
| 対応の開始時期 | 各社の実装案内と、自社サイトの反映確認をいつ行うか |
新しい設定は、複数社への希望を伝える入口をそろえます。ただ、今日書いた2行が、今日からすべての企業・サービスに同じ効果を持つわけではありません。現行の設定を把握し、対応開始の案内を確認しながら、自社の公開方針に合わせて導入を進めてください。
出典・確認範囲
- OpenAI:Making it easier for websites to express AI training preferences(2026年10月30日)。共通信号への対応方針、数か月以内の実装目標、既存設定の継続。2026年11月1日確認。
- Google Search Central:Supporting a shared AI training control for websites(2026年10月30日)。共通設定とGoogle-Extendedの関係、個別指定、Geminiアプリでのグラウンディング。2026年11月1日確認。
- Microsoft Bing:Your content, your choice: clearer preferences for training and grounding(2026年10月30日)。2027年2月1日の適用開始、学習とグラウンディングの独立設定、旧設定の移行。2026年11月1日確認。
- Kevin Kelley:IETF AI Preferencesメーリングリストへの草案紹介(2026年10月30日)。Anthropicの実装着手、既存設定の継続。会社ブログでの発表とは区別して参照。2026年11月1日確認。
- IETF個人草案:Machine-Readable Training Preference Signal(-00)(2026年10月30日)。記法、パスの照合、全クローラー向け指定との分離、巡回規則との独立性。IETFの正式標準ではない作業文書。2026年11月1日確認。
- Google:List of Google's common crawlers/Google-Extended(最終更新2026年10月30日UTC)。「early 2027」の予定、対象となる学習・グラウンディング、Google検索への掲載・順位との関係。2026年11月1日確認。