
AIコストを抑えるには、安いモデルの料金表を探すだけでは足りません。1回の返答が安くても、何度もやり直し、最後に人が書き直しているなら、仕事全体では高くつくからです。見るべきなのは、正しく完了した仕事1件に、どれだけ費用がかかったかです。
Googleは2026年11月3日、Geminiのモデルや考える深さを使い分ける検証を公開しました。注目したいのは、振り分けの仕組みを作る前に、軽い設定だけで仕事が済むかを比べている点です。この記事では、その考え方を中小企業の問い合わせ対応などに当てはめて整理します。[1]
仕様の確認は2026年11月4日時点。Googleの結果は50問・各設定1回の実験です。以下の業務例はCAGが作成した設計例で、Geminiや分類用AIを実行して測った結果ではありません。
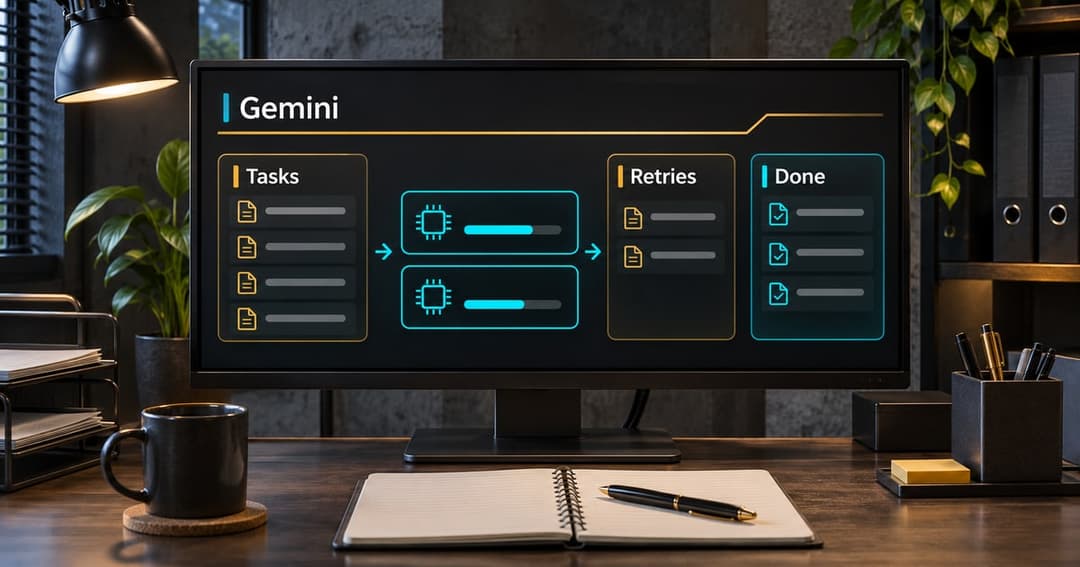
01 単価が下がっても、AIコストが減らない理由
AIのAPIは、自社のシステムからモデルを呼び出す接続口です。多くは、入力・出力の量を表す「トークン」などに応じて課金されます。ただし、料金表の単価と、仕事1件を終える費用は同じものではありません。入力、出力、キャッシュ、外部ツールなど、利用する機能の課金条件も確認が必要です。[4]
たとえば、問い合わせから注文番号を抜き出す仕事を考えてみます。安いAIがすぐに返答しても、注文日を番号と取り違えて再実行になれば、呼び出しは増えます。確認用の別のAIを呼んだり、過去の会話をもう一度読ませたりすれば、その分も積み上がります。
Googleが示した評価の軸は、処理全体の費用を、検証に合格した仕事の数で割るというものです。失敗した試行にかかった費用も含めるため、安い返答を大量に作るだけでは良い成績になりません。[1]
会社で使うときは、APIの費用と人の作業量を分けて記録すると、改善の理由が見えます。「AIの請求は減ったが、担当者の確認が増えた」という変化も拾えます。人件費を含む総費用に換算するなら、どの作業時間を、どの基準で金額にするかも揃えます。
| 見るもの | 分かること | それだけでは分からないこと |
|---|---|---|
| 料金表の単価 | 同じ量を処理するときの価格 | やり直しを含む仕事全体の費用 |
| APIの利用額 | AI処理に支払った金額 | 何件が正しく完了したか |
| 完了1件あたりの費用 | 成功した仕事を得るための費用 | 人の修正にかかった時間 |
| 担当者の修正時間 | 業務に残った手間 | AI単体の利用額 |
最初に決めたいのは、モデル名より「完了」の定義です。注文番号を抜き出すなら、文字列が出たことではなく、元の問い合わせの正しい番号と一致したことを完了にします。回答案なら、必要な情報が揃い、担当者が使える状態になったかで判定します。
02 使い分ける前に「考える深さ」を見直す
仕事を複数のモデルに振り分けると、分岐や設定の管理も増えます。その前に、同じモデルの軽い設定で、必要な品質を満たせないかを確かめる方法があります。
Geminiには、返答前の推論にどれくらい取り組むかを調整する設定があります。これが「考える深さ」です。対応する設定や指定方法はモデル・APIによって異なるため、利用する組み合わせの公式ドキュメントで確認します。[2]
ここで混同しやすいのが、生成する量の上限です。「短く答えさせる」と「内部であまり考えさせない」は別の指定です。出力の上限を小さくしても、それだけで推論にかかる費用を狙いどおり減らせるとは限りません。上限が小さすぎると、推論の途中で止まり、回答が出ない場合もあります。[1][2]
| 設定 | 主に調整するもの | 確認したい点 |
|---|---|---|
| 出力の上限 | 生成できるトークン量の上限 | 回答が途中で切れていないか |
| 考える深さ | 推論に使う取り組みの度合い | 品質と待ち時間がどう変わるか |
| モデルの選択 | 処理するAIそのもの | 得意な仕事と料金条件が合うか |
Googleの実験では、Gemini 3.8 Flashの考える深さをLOWにした構成と、分類用AIを組み合わせた振り分け構成が、どちらも50問すべてに正答しました。この結果から、最初から複雑な振り分けを足すより、まず軽い設定を比較相手にする意義が読み取れます。自社業務でも同じ品質になることを保証する結果ではありません。[1]
設定を比べる間は、入力する資料や合格の基準を揃えます。設定と同時に質問文まで変えると、費用や品質が変わった理由を切り分けにくくなるからです。
03 軽い仕事と難しい仕事を、どう振り分けるか
軽い設定だけでは足りない仕事が残ったら、次に使い分けを考えます。振り分け役のAIは、長い文章を作るためではなく、どの処理へ回すかを判定するためのAIです。Googleの記事ではTypeSafeのJevを例にしていますが、Googleと同社の提携や製品推奨の発表ではありません。[1]
設計で難しいのは、「簡単な仕事」という言葉を、判定できる条件に変えるところです。文章が短くても、複数の条件を照合する必要があるかもしれません。長い文章でも、決まった箇所から番号を抜き出すだけなら、処理自体は単純かもしれません。
以下は、問い合わせ対応に当てはめた設計例です。特定のモデルで精度を確認したものではありません。
| 仕事 | 判定条件の例 | 次の処理の設計例 |
|---|---|---|
| 注文番号の抽出 | 本文に番号が明記されているか | 軽いモデルで抽出し、形式を確認 |
| 定型質問の回答案 | 登録済みの案内だけで答えが揃うか | 案内を参照して下書きを作る |
| 複数条件を含む相談 | 複数の契約条件や例外を照合する必要があるか | 推論を使うモデルで回答案を作る |
| 情報不足・判断が曖昧 | 回答に必要な情報が欠けているか | 確認事項を作り、人の確認待ちへ回す |
このように、判定条件を先に書けば、振り分けの正誤も確認できます。後から「難しかったから」と説明するのではなく、どの条件で分岐したかを記録できます。
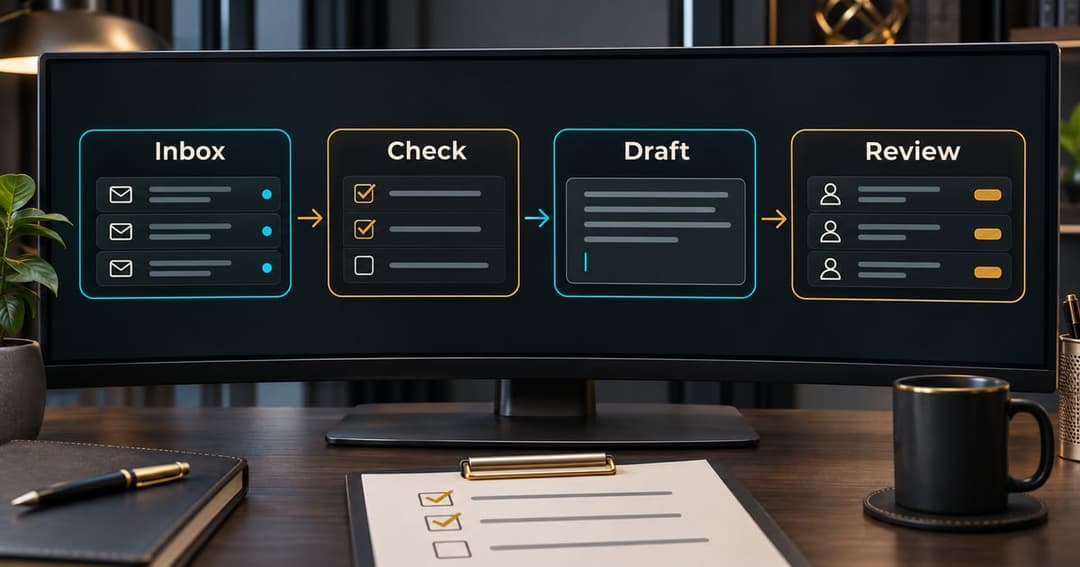
経路の選択と、結果が正しいことも別です。軽い経路へ回した処理でも、必須項目が欠けたり、形式が合わなかったりしたら、その場で完了にしません。再処理や人の確認へ渡す受け皿を用意し、同じ入力のまま何度も試す回数には上限を置きます。
04 AIを切り替えると、かえって高くなる場面
使い分けが向くのは、短く独立した処理だけとは限りませんが、長い資料を何度も読む仕事では別の費用も効きます。それが同じ入力内容の処理を再利用するキャッシュです。
Geminiのキャッシュには、対象モデルや最低入力長などの条件があります。共通する資料や指示を繰り返し渡す仕事では、どれだけ再利用されたかを、実際の利用情報で確認します。「キャッシュがあるはず」と見込んだ費用だけで予算を決めないようにします。[3]
たとえば、同じ契約書を読みながら、複数回に分けて質問する仕事です。途中で別のモデルへ切り替えると、前のモデルで得ていた再利用の利点を、そのまま引き継げるとは限りません。切替先への資料入力も含めて比べる必要があります。Googleも、モデルの切り替えとキャッシュの効率がぶつかる点を挙げています。[1]
実務での分け方としては、注文番号の抽出など、必要な入力が小さい処理を使い分けの入口にする。一方、同じ長い資料を何度も参照する会話は、同じモデルで続ける構成を比較対象に残す。この2つを別々に測ると、改善しやすくなります。
振り分け役にも費用と待ち時間があります。追加した仕組みの費用、モデルを切り替える際の入力、失敗時の再処理まで含めて、元の構成を上回ったかを判断します。
05 自社で始めるなら、何を測ればいいか
最初の対象は、完了の基準を揃えやすい仕事が扱いやすいでしょう。問い合わせからの項目抽出、決まった形式への整形、社内向けの回答案などです。まず人が確認できる状態で試し、仕事の種類ごとに記録します。
比較する順番は、現在の構成、同じモデルの軽い設定、必要に応じた使い分け、です。すべてを一度に変えず、同じ入力群で、同じ合格基準を使います。最初に作った条件に合う例だけでなく、誤字、情報不足、複数の用件、判断が割れる例も含めます。
| 記録する項目 | 記録のしかた | 改善を判断する視点 |
|---|---|---|
| 正しく完了した割合 | 合格した件数と、投入した全件数を残す | 安さのために品質を落としていないか |
| 完了1件あたりのAI費用 | 失敗・再実行を含む費用を、合格件数で割る | やり直し込みでも下がったか |
| 待ち時間 | 受付から使える結果が揃うまで測る | 通常の待ち時間と、長く待った例はどうか |
| 人の修正時間 | 担当者が確認・修正した時間を残す | 人へ手間を移しただけになっていないか |
| 振り分け・再処理の理由 | 選んだ経路、失敗理由、試行回数を残す | どの種類の仕事が費用を増やしているか |
ここでの合格は、文章の自然さだけで決めません。注文番号が合っているか、必要な案内が抜けていないか、元の資料にない約束を加えていないか。業務に即した確認項目を用意します。
何度か条件を変える場合は、設定調整に使う入力と、最後の確認に使う未使用の入力を分けます。測る回によるばらつきも残せば、都合のよい一度だけを根拠に導入することを避けられます。
Googleの記事は、小規模な自動採点の実験から得られた知見です。検証コードはオープンソースの審査後に公開する予定とされており、この記事で同じ実験を再現したわけではありません。[1]
AIコストの管理で先に揃えたいのは、料金表の比較より、何をもって仕事が終わったとするか、そのために何を使ったかの記録です。それがあれば、軽い設定で十分なのか、使い分けが効くのか、人の確認に費用をかけるべきなのかを、自社の仕事で判断できます。
出典・確認範囲
- Google Developers Blog「Cost per task: Using cheap classifiers to route across Gemini models and thinking levels」(2026-11-03公開、2026-11-04確認)。50問・各設定1回、難易度は人が付与し自動採点。Googleの検証と、CAGが作成した業務設計例を区別している。
- Google「Gemini thinking」(2026-11-04確認)。推論設定と出力上限の説明。対応する設定・既定・指定方法はモデルとAPIによって異なる。
- Google「Context caching」(2026-11-04確認)。キャッシュの対象、条件、利用情報。APIごとの対応を確認し、本文では一律の割引率を示していない。
- Google「Gemini API pricing」(2026-11-04確認)。モデルと機能ごとの課金条件。本文は特定プランの単価比較ではなく、仕事全体の費用を測る設計を扱う。