気になるAIツールを、分かりやすく
2026年9月22日、AnthropicがClaude Opus 5.5を公開しました。発表の見出しは「ほとんどの仕事でClaude Fable 5.1と同じ水準、動かす費用はOpus 5より40%安い」です[1]。
CAGで同じ修正課題をOpus 5とOpus 5.5に計15回解かせたところ、考える深さ(effort)を同じ high にそろえても、1回あたりの費用は約44%下がりました。下がった分の多くは単価の値下げで、残りはOpus 5.5が使うトークン(AIが読み書きする文字の単位)が少なかったことによります。一方で、乗り換えるとエラーを出さずに変わることが、この値下げとは別にあります。
- 何が出たか(価格・提供先・Claude Codeは2.1.280以上が必要)
- 発表のベンチマーク表を1行ずつ読む
- 「40%安い」を作っている3つの要素
- 実測:同じ課題を5つの条件で15回
- エラーを出さずに変わること
- 400エラーで止まる変更と、別のモデルに回される依頼
- 乗り換える前に確かめること
01 何が出たか。単価は2割、キャッシュ読み込みは6割下がった
Opus 5.5は「Claude 5.5」世代の最初のモデルです。発表によると、Sonnet 5.5とHaiku 5.5は数週間以内に続きます[1]。仕様と料金を前世代と並べるとこうなります[2][3]。
| 項目 | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| 入力(100万トークンあたり) | $4 | $5 |
| 出力(同) | $20 | $25 |
| キャッシュ読み込み(同) | $0.20(入力の0.05倍) | $0.50(入力の0.1倍) |
| キャッシュ書き込み 5分/1時間(同) | $5 / $8 | $6.25 / $10 |
| 一度に扱える量(コンテキスト) | 100万トークン | 100万トークン |
| 1回の最大出力 | 12.8万トークン | 12.8万トークン |
| effortの既定値 | medium | high |
| 思考(thinking)をOFFにできるか | できない(常にON) | high以下ならできる |
キャッシュとは、一度読み込ませた指示やファイルを次の呼び出しで使い回す仕組みです。AIエージェントやコーディングの費用は、このキャッシュ読み込みが大半を占めると発表は書いています[1]。そこが6割下がったことが、単価表でいちばん大きな変化です。
提供先はClaude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundryです[2]。出力を最大2.5倍速くするFast mode(入力$8・出力$40)もありますが、使えるのはClaude APIだけで、クラウド経由では選べません[4]。
Claude Codeは2.1.280でOpus 5.5を「既定のOpusモデル」にしました[5]。CAGで試したところ、それより古い2.1.278では--model claude-opus-5-5を指定した時点で400エラーが返り、「2.1.280以降が必要」と表示されました。社内でClaude Codeを配っている場合、更新が遅れている人はOpus 5.5を選べません。逆に、Claude Codeで既定のOpusを使っている人は、更新した時点でOpus 5.5に切り替わります。
02 ベンチマーク表を1行ずつ読む
発表には、Opus 5.5・Fable 5.1・Opus 5・OpenAIの2モデルを並べた表があります。9項目のうちOpus 5.5が首位なのは7つでした(残り2つはGPT-6 Astra)[1]。
| 項目 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| GDPval-AA v2.1(Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity's Last Exam(ツールあり) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0 | 81.8% | 80.7% | 74.0% | — | — |
| Chartography(ツールあり) | 89.0% | 88.4% | 83.4% | — | — |
読むときに押さえておく点が3つあります。
- Opus 5.5の数字は最上位の
maxで測ったものです(Terminal-Bench 4.0だけはxhigh)。既定のmediumで使うと表の数字にはなりません - Anthropic自身が「差を割り引いて読むように」と書いています。この水準ではベンチマークの差が実務の差の目安になりにくく、社内で使った感触ではFable 5.1との差は表の数字より小さい、としています
- 評価は安全策を有効にしたまま行われました。安全策が作動したサイバーセキュリティの課題はOpus 4.8が、生物学などの課題はOpus 5が代わりに解いており、Opus 5.5のスコアを下げている可能性があると注記されています
もう1つ、表の外に面白い数字があります。FrontierCodeでは、既定の medium が54.6%で、表に載っている max の54.4%をわずかに上回っていました[1]。誤差の範囲ですが、「深く考えさせれば必ず良くなる」わけではないことが分かります。
 関連記事 | 2か月前の前世代Claude Opus 5を、分かりやすく ──価格据え置きで世代交代、倍の値段の最上位モデルを上回った新モデルを解説
→
03 「40%安い」を作っている3つの要素
発表の説明では、40%は次の3つを合わせた結果です[1]。
- 単価の値下げ:入力・出力は2割引、キャッシュ読み込みは6割引
- 1つの作業に使うトークンが少ない:「トークンあたりが安く、作業あたりのトークンも少ない。差し引きで40%」
- 既定の設定での比較:「既定の設定では、典型的な作業でOpus 5より40%安い」
3つ目に注意が要ります。Opus 5.5は、effortを指定しないと medium で動きます。Opus 5の既定は high でした[6]。既定どうしの比較は、Opus 5.5のほうを1段浅く考えさせた比較ということになります。
加えて、移行ガイドにはこういう一文があります[7]。
同じeffortの設定では、Opus 5.5はOpus 5より1ターンあたり多く考える傾向がある。特に
Anthropic「Prompting Claude Opus 5.5」Calibrate effort(CAG訳)xhighとmaxで顕著。Opus 5で使っていたeffortをそのまま使うと、ターンが長くなり出力トークンが増えると考えてほしい。
読み方によっては、40%の大半は「既定を1段下げたこと」で出ていて、今の high を持ち込めば安くならない、とも読めます。そこで実際に測りました。
04 実測:同じ課題を5つの条件で15回
課題は、月末最終日の利用が集計から漏れる小さなバグの修正です。リファクタで「挙動は変えていない」はずのコードに、8月31日0時以降の利用が数えられない不具合を仕込み、「原因を特定して最小限に直し、境界のテストを足し、テストが通ることを確かめて報告する」ように頼みました。Claude Code 2.1.280から、モデルとeffortだけを変えて各3回ずつ実行しています[8]。
正解かどうかは、モデルに見せていない別のテストで判定しました(8月31日の0時・18時半・23時59分59秒、9月1日0時、12月末から1月への繰り越し)。15回すべてが正解でした。
| 条件 | 1回あたりの費用 | Opus 5 highとの差 | 出力トークン | 所要時間 |
|---|---|---|---|---|
| Opus 5 / high(Opus 5の既定) | $0.289 | — | 2,672 | 36.3秒 |
| Opus 5 / medium | $0.264 | −8.7% | 2,296 | 37.3秒 |
| Opus 5.5 / low | $0.102 | −64.7% | 985 | 13.7秒 |
| Opus 5.5 / medium(Opus 5.5の既定) | $0.156 | −46.0% | 2,103 | 23.7秒 |
| Opus 5.5 / high | $0.163 | −43.8% | 2,311 | 25.0秒 |
この課題では、effortをそろえても安くなりました。Opus 5.5を high で動かしても medium より4%高いだけで、Opus 5の high より43.8%安く済んでいます。出力トークンもOpus 5の high より少なく、移行ガイドの「同じeffortなら多く考える」は、少なくともこの規模の課題では費用に表れませんでした。
では、下がった分はどこから来たのか。Opus 5の high が使ったトークンの量はそのままに、Opus 5.5の単価を当てはめて計算し直すと分けられます。
内訳は単価の差で34%、トークン量の差で残りの15%です。単価の差が大きいのは、この課題の費用の中身がキャッシュだったからです。Opus 5の high の費用のうち、キャッシュ書き込みが41%、キャッシュ読み込みが36%、出力は23%でした。出力単価だけを見ていると、値下げの効き方を小さく見積もります。
顧客の声とも数字が合いました。発表に載っているFactoryは「medium のOpus 5.5が high のOpus 5に並び、出力トークンは20〜25%少なかった」と報告しています[1]。今回の実測では、medium のOpus 5.5の出力トークンは high のOpus 5より21%少なく、同じ範囲に入っています。
ただし、安くなった分には「やった作業の量」も含まれます。Opus 5は毎回テストを4本足しましたが、Opus 5.5は2〜3本でした(どちらも境界の抜けは正しく押さえています)。low のOpus 5.5は、修正・テスト追加・テスト実行を1つのコマンドにまとめ、2手で終えています。
測ったのは30秒前後で終わる小さな課題1種類で、各条件3回だけです。数時間かかる長い作業や、xhigh・max は測っていません。移行ガイドの警告が特に当てはまるのはそちらなので、長い作業では自社の作業で測り直してください。
05 エラーを出さずに変わること
費用とは別に、乗り換えただけで振る舞いが変わる点が公式に挙がっています[2][7]。どれもリクエストは成功するので、エラーでは気づけません。
| 変わること | 何が起きるか | 公式の対処 |
|---|---|---|
| effortの既定がmediumに | 指定していないリクエストが、Opus 5より1段浅く動く | effortを明示して、自社の評価で段階ごとに測り直す |
| 同じeffortで多く考える | 考えた分も max_tokens に数えるため、Opus 5で思考OFF前提にしていた上限だと返答が途中で切れうる | max_tokens に余裕を持たせる(長いコーディング作業では、上限の12.8万でうまくいったと公式が書いている) |
| ツールの合間の途中経過 | 「次にテストを書きます」のような短い説明が text でなく thinking ブロックで届く。既定では中身が空なので、途中経過を表示している画面が黙る | thinking.display を updates(ベータ)か summarized にして表示し直す |
| 思考ブロックがモデルと会話に紐づく | Opus 5.5の思考を読めるのはFable 5.1とMythos 5.1だけ。ルーターやフォールバックで他のモデルに移ると、それまでの思考を失って続きを解く | 会話は追記だけにする(途中で指示やツールを書き換えない) |
途中経過の変化は、今回の実測にも出ていました。Opus 5の high は、ツールを呼ぶ直前に「まずファイルを見ます」「次は境界のテストです」といった短い文を3回で計7回、通常の文章として返しています。medium と high のOpus 5.5では、6回で1回だけでした。代わりに、同じ位置に thinking ブロックが5回届いており、うち2回は中身が空でした。APIで自社の画面を作っている場合、表示の設定を直さないと、この部分がそのまま空白になります。
 関連記事 | 同じ変更を先に入れたモデルClaude Fable 5.1 が来た ──乗り換えで止まる3つの変更と、エラーが出ないまま変わる7つの挙動
→
06 400で止まる変更と、別のモデルに回される依頼
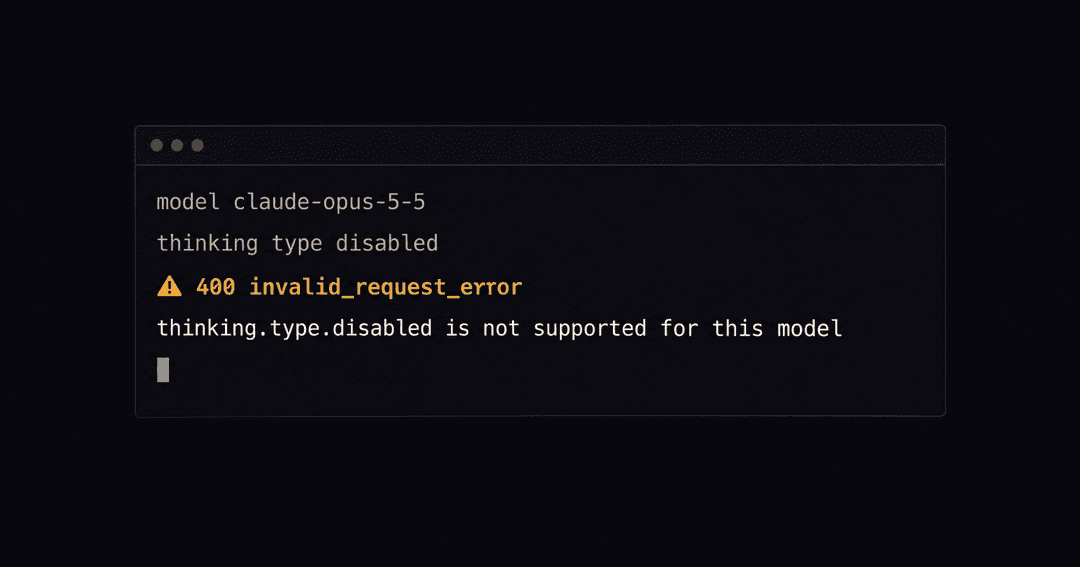
こちらはエラーで止まるので、気づくことはできます。Opus 5で動いていたコードが400を返すのは4か所です[2]。
| 400になる書き方 | 代わりの書き方 |
|---|---|
思考をOFFにする(thinking: disabled)/手動の思考予算(enabled) | thinking を書かず、effortで深さを調整する |
ツールを強制する(tool_choice の any と tool) | auto + strict tool use か構造化出力にし、使ってほしい場面をプロンプトに書く |
| 思考ブロックを残したまま、途中で指示やツールを書き換える(2026年8月31日以降に作ったアカウント) | 会話を追記だけにする。指示の変更は会話途中のシステムメッセージで行う |
旧来の画面操作ツール computer_20251124(Claude APIとGoogle Cloud) | computer_toolset_20260801 に移る。Amazon Bedrockでは旧来のままでよい |
もう1つは安全策です。Opus 5.5はサイバーセキュリティと生物学の能力が高く、Fable 5.1と同じ種類の安全策が入りました[1]。
- サイバーセキュリティの作業の多くはOpus 4.8に回されます。ふだんの開発でバグを見つけて直す範囲は対象外です。防御側の実務家向けには認定プログラム(Cyber Verification Program)を数週間以内に広げる、としています
- 拒否はエラーでなく、HTTP 200で返ります。
stop_reasonがrefusalになり、stop_detailsに分野(cyber・bio・reasoning_extraction)が入ります。ステータスコードだけ見ている処理は、拒否を成功として扱います[7] - 自動で別のモデルにやり直させる設定(server-side fallback)がありますが、思考を本文に書き出させようとして拒否された
reasoning_extractionは、やり直しの対象外です
安全面では、Anthropic社内の約2,000の場面で行動を確かめる監査で、最近のどのClaudeモデルよりも良い成績だったと書かれています。閉じ込めの境界を越えようとする頻度も、Opus 5より約85%少なかったそうです。同時に、評価されていると疑っている兆候がよく見られるとも書いており、評価の結果をそのまま実環境に当てはめられるとは言っていません[1]。
07 乗り換える前に確かめること
- effortを明示する。書いていなければ、既定が
mediumに下がります。highを明示した場合でも、今回の課題では費用は4%しか増えませんでした - コードの中から
thinking: disabledとtool_choice: any / toolを探す。残っていると400で止まります - 自社の画面で途中経過を出しているなら、
thinking.displayを設定する。設定しないと、ツールを呼ぶ合間の表示がエラーなしで消えます - 拒否(
stop_reason: refusal)を扱う処理を入れる。HTTP 200で返るので、ステータスコードでは拾えません - ルーターやフォールバックで別のモデルに回しているなら、思考が引き継がれないことを前提にする
- 社内のClaude Codeを2.1.280以上にそろえる。古い版ではOpus 5.5を選んだ時点で400になります
- 費用は、出力単価でなくキャッシュを含めた実費で比べる。今回の課題では、費用の77%がキャッシュの読み書きでした
| 発表の見出し | CAGの実測・docsで分かったこと | |
|---|---|---|
| 安さ | 既定の設定でOpus 5より40%安い | effortをhighにそろえても43.8%安い(小さな課題・各3回) |
| 安さの中身 | 単価の値下げとトークンの少なさ | 単価の差で34%、トークン量の差で15%。効いたのはキャッシュの単価 |
| 性能 | ほとんどの仕事でFable 5.1並み | 9項目中7項目で首位。ただしmaxで測った値で、差は割り引いて読むよう本人が注記 |
| 移行 | モデル名を変える | 400が4か所、エラーなしの変化が4つ、拒否は200で返る |
この記事の調査・実測・執筆も、Opus 5.5で動くClaude Codeで行いました。今回の課題でいちばん大きかった差は、正答率ではなく費用でした。
値下げはキャッシュに効き、移行の手間は画面に表示されないところに出る。
AIの切り替えや費用の見直しを相談したい方へ
電脳技巧集団(AI職人ギルド)は、AI駆動で業務システムをつくっています。どのモデルをどの設定で使うか、自社の作業で測って決めるところから相談できます。お問い合わせはこちら
出典・注記
- Anthropic「Introducing Claude Opus 5.5」2026年9月22日。https://www.anthropic.com/claude-opus-5-5
- Claude Platform Docs「What's new in Claude Opus 5.5」(2026年9月23日閲覧)。https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- Claude Platform Docs「Pricing」(2026年9月23日閲覧)。https://platform.claude.com/docs/en/about-claude/pricing
- Claude Platform Docs「Fast mode」(2026年9月23日閲覧)。https://platform.claude.com/docs/en/build-with-claude/fast-mode
- Claude Code CHANGELOG 2.1.280(2026年9月23日閲覧)。https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Claude Platform Docs「Effort」(2026年9月23日閲覧)。https://platform.claude.com/docs/en/build-with-claude/effort
- Claude Platform Docs「Migrating to Claude Opus 5.5」「Prompting Claude Opus 5.5」(2026年9月23日閲覧)。https://platform.claude.com/docs/en/models/opus-5-5/migration-guide / https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-opus-5-5
- CAGによる実測(2026年9月23日)。Claude Code 2.1.280の非対話モードで、ユーザー設定・フック・MCPを読み込まない状態にそろえ、モデル(
claude-opus-5/claude-opus-5-5)とeffortだけを変えて各3回、計15回実行。費用はClaude Codeが報告する定価換算の値で、1時間のキャッシュ書き込み単価で計算し直すと一致しました。15回の合計は約2.92ドル。課題はテストを含めて約70行のPythonコード1種類で、長時間の作業やxhigh・maxは測っていません。ベンチマーク表と顧客の声はAnthropicの発表からの引用で、CAGの検証ではありません。