気になるAIツールを、分かりやすく
2026年9月28日、AnthropicがClaude Sonnet 5.5を公開しました。発表の冒頭で、Anthropicは「Sonnet 5から明確に良くなり、30%以上速く、ほとんどの作業で費用は最大30%下がる」と説明しています[1]。
CAGで同じ修正課題をSonnet 5とSonnet 5.5に計54回解かせたところ、考える深さ(effort)を同じにそろえると、1回あたりの費用は平均で27〜36%下がり、所要時間は平均で55〜58%短くなりました。単価はSonnet 5と同じ(入力$2・出力$10)なので、下がった分はすべて、使うトークン(AIが読み書きする文字の単位)とツールを呼ぶ往復の少なさから来ています。一方で、乗り換えるとエラーを出さずに変わることが、この安さとは別にあります。
- 何が出たか(単価・提供先・Claude Codeの版)
- 発表のベンチマーク表を1行ずつ読む
- 「最大30%安い」の3つの読み方
- 実測:同じ課題を6つの条件で54回
- エラーを出さずに変わること
- 400エラーで止まる変更と、別のモデルに回される依頼
- 乗り換える前に確かめること
01 何が出たか。単価は据え置き、Opus 5.5の半額
Sonnet 5.5は「Claude 5.5」世代の2つ目のモデルです。9月22日のOpus 5.5に続くもので、Haiku 5.5は数週間以内に加わる予定です[1]。Anthropicの位置づけは、複雑な判断が要る仕事はOpus 5.5、範囲がはっきりした日常の作業・バグ修正・資料やスライドや表計算づくりはSonnet 5.5、という使い分けです[1]。仕様と料金を前世代・上位モデルと並べるとこうなります[2][3]。
| 項目 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| 入力(100万トークンあたり) | $2 | $2 | $4 |
| 出力(同) | $10 | $10 | $20 |
| キャッシュ読み込み(同) | $0.20(入力の0.1倍) | $0.20 | $0.20 |
| キャッシュ書き込み 5分/1時間(同) | $2.50 / $4 | $2.50 / $4 | $5 / $8 |
| 一度に扱える量(コンテキスト) | 100万トークン | 100万トークン | 100万トークン |
| 1回の最大出力 | 12.8万トークン | 12.8万トークン | 12.8万トークン |
| effortの既定値(API) | high | high | medium |
| 思考(thinking)をOFFにする書き方 | between_tools(high以下) | disabled | できない(常にON) |
| 知識の期限 | 2026年6月 | 2026年1月 | 2026年6月 |
キャッシュとは、一度読み込ませた指示やファイルを次の呼び出しで使い回す仕組みです。読み込みの単価は入力の1割($0.20)で、3つのモデルで同じです。
Sonnet 5の$2/$10は、6月30日の発売時に「8月末までの導入価格」とされ、9月1日から$3/$15になる予定でした。Anthropicは8月10日にこの$2/$10を正式な価格にすると発表し、値上げは行われません[4]。Sonnet 5.5の「据え置き」は、この$2/$10のことです。
提供先はClaude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundryです[2]。入力と出力を保存しない「ゼロデータ保持」でも使えます[1]。
Claude Codeは2.1.284でSonnet 5.5を追加し、APIで使う既定のSonnetモデルにしました[5]。CAGで試したところ、1つ前の2.1.283でも --model claude-sonnet-5-5 を指定すれば動きますが、「未対応のモデル」という警告が出て、費用の表示がほぼ2倍になりました。同じ呼び出し(Reply with exactly: OK)を2つの版で1回ずつ実行した結果です。
| Claude Code 2.1.283 | Claude Code 2.1.284 | |
|---|---|---|
| 警告 | 「未対応のモデル」 | なし |
| キャッシュ書き込み(トークン) | 39,093 | 35,380 |
| キャッシュ読み込み(トークン) | 29,599 | 21,393 |
| 表示された費用 | $0.319 | $0.146 |
| Sonnet 5.5の単価で計算した値 | $0.162 | $0.146 |
2.1.283の表示は、Opus 5.5の単価(入力$4・出力$20・1時間の書き込み$8・読み込み$0.20)で計算した値とちょうど一致しました。2.1.284では、表示がSonnet 5.5の単価での計算値と一致しています(2回はキャッシュの状態が違い、トークン数も違うので、金額どうしは比べていません)。古いClaude Codeのままだと、Sonnet 5.5が実際の倍近い費用に見えます。
02 ベンチマーク表を1行ずつ読む
発表には、Sonnet 5.5・Sonnet 5・Opus 5.5・OpenAIのGPT-6 Solを並べた表があります[1]。8項目のうち、Sonnet 5.5がSonnet 5を上回ったのは8つすべてで、Opus 5.5を上回ったのはTerminal-Bench 4.0の1つだけです。
| 項目 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0(コマンド操作で進める作業) | 70.6% | 10.3% | 66.4%※1 | — |
| FrontierCode 1.1(変更がそのまま取り込めるか) | 52.1%(xhigh)/46.2%(max) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0(実際の開発セッション由来) | 55.5% | 34.1% | 57.8% | — |
| GDPval-AA v2.1(44職種の実務・Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1(長い知的作業・Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam(ツールあり) | 64.5% | 54.9% | 67.7% | — |
| OSWorld 2.1(画面操作・partial) | 80.1% | 57.0% | 81.8% | — |
| Chartography(グラフの読み取り・ツールなし) | 61.6% | 15.6% | 64.4% | 53.6% |
※1 Opus 5.5のTerminal-Bench 4.0は、最も高いxhighで測った値です[1]。Elo(GDPval-AAとAA-Briefcase)は、対戦形式の比較で付ける点数で、大きいほど良い値です。
- Opus 5.5が上なのは7項目です。差は小さく(GDPval-AAは2点、CursorBenchは2.3ポイント)、それでもAnthropicは、複雑で答えの決まっていない、判断を保ち続ける仕事ではOpus 5.5のほうが明確に強い、と書いています[1]
- 深く考えさせるほど良いとは限りません。FrontierCodeでSonnet 5.5の点は、最上位のmaxで46.2%、1段下のxhighで52.1%でした。発表の脚注は、maxでは作業を分担する別のAI(サブエージェント)に多数のレビューをさせる動きが出やすく、範囲外の修正やタイムアウトで減点された例がある、と説明しています[1]
- GDPval-AAとAA-Briefcaseは、第三者のArtificial Analysisが公開前の環境で測ったもので、構造化出力(決まった形式で答えさせる機能)の不具合(修正済み)でSonnet 5.5の点が低く出た可能性がある、と脚注にあります[1]
- 「—」は、その項目の数字が表に載っていないという意味です。Terminal-BenchとCursorBenchでは、GPT-6 Solの数字が公開されていないと発表に書かれています[1]
 関連記事 | 1週間前に出た上位モデルClaude Opus 5.5とは ──「Opus 5より40%安い」を15回の実測で確かめ、乗り換えで変わることを整理
→
03 「最大30%安い」の3つの読み方
Sonnet 5.5は単価がSonnet 5と同じなので、安くなるなら理由は「同じ仕事に使うトークンが少ない」ことです。発表の中だけで、安さは3つの比べ方で書かれています[1]。
| 比べ方 | 発表の数字 | 何と何を比べているか |
|---|---|---|
| ふだんの作業 | ほとんどの作業で、1タスクあたりの費用が最大30%下がる | Sonnet 5の同じ作業(Anthropic社内のテスト) |
| 顧客が自社の作業で測った値 | Balyasny Asset Management:1回の回答に使うトークンが約12.1万(Sonnet 5は約49.7万)/Box:合計トークンが12%減で2.4倍速/Slack:出力トークンが約14%減 | それぞれの顧客の作業(Anthropicが掲載した顧客の声) |
| ベンチマークの費用と点数の図 | FrontierCode:同じhighで10ポイント高く、費用は約15分の1/Terminal-BenchとCursorBench:lowまたはmediumが、Sonnet 5の最高点を10分の1未満の費用で上回る/AA-Briefcase:mediumで約9分の1 | FrontierCodeは同じ設定どうし。そのほかは「Sonnet 5の最高設定の点」との比較 |
読み方の要点は、どの相手と、どの設定で比べているかです。1つ目と2つ目は同じ仕事の前後比較ですが、3つ目には「Sonnet 5の最高点」を基準にした図が混ざり、費用の差は10倍前後まで開きます。自社の仕事がどれに近いかは発表から分からないので、実際に測りました。
04 実測:同じ課題を6つの条件で54回
課題は、前回のOpus 5.5の記事と同じ、月末最終日の利用が集計から漏れる小さなバグの修正です。リファクタで「挙動は変えていない」はずのコードに、8月31日0時以降の利用が数えられない不具合を仕込み、「原因を特定して最小限に直し、境界のテストを足し、テストが通ることを確かめて報告する」ように頼みました。Claude Code 2.1.284から、モデルとeffortだけを変えて各9回ずつ実行しています[10]。
正解かどうかは、モデルに見せていない別のテスト(8月31日の0時・18時半・23時59分59秒、9月1日0時、12月末から1月への繰り越し)で判定しました。54回すべてが正解でした。
| 条件 | 費用(1回) | Sonnet 5との差 | 出力トークン | 往復 | 所要時間 |
|---|---|---|---|---|---|
| Sonnet 5 / low | $0.291 | — | 1,840 | 9.8回 | 28.3秒 |
| Sonnet 5.5 / low | $0.185 | −36.4% | 946 | 3.3回 | 12.1秒 |
| Sonnet 5 / medium | $0.275 | — | 1,937 | 8.9回 | 27.3秒 |
| Sonnet 5.5 / medium(Claude Code・アプリの既定) | $0.186 | −32.6% | 970 | 3.3回 | 11.4秒 |
| Sonnet 5 / high | $0.284 | — | 2,568 | 8.7回 | 36.4秒 |
| Sonnet 5.5 / high(APIの既定) | $0.208 | −26.9% | 1,476 | 5.1回 | 16.6秒 |
この課題では、effortをそろえると、Sonnet 5.5は費用が27〜36%、所要時間が55〜58%下がりました(全54回の平均)。発表の「最大30%」は、費用の下がり幅とほぼ重なります。ただし差は周によって動きます。3周に分けて(周×effortの9通りで)見ると、費用の差は20〜44%、所要時間の差は47〜66%でした。この幅には、Sonnet 5の各条件の1回目だけキャッシュがまだ冷えていて、書き込みが約7.4万トークンと、2回目以降(約3.8万トークン)のほぼ2倍だった影響も含まれます。各条件の1回目を除いて比べ直すと、費用の差は22〜35%、所要時間の差は54〜58%です。
下がった理由は、往復の回数です。AIは、ファイルを読む・直す・テストを走らせるといった道具を使うたびに、結果を受け取って次の手を考えます。この1周が往復(ターン)です。Sonnet 5は平均8.7〜9.8回の往復(ツール呼び出しは27回の実行で合計219回)かけ、たとえば medium の1回目は、ファイルを探し、3つのファイルを1つずつ読み、直し、テストを足し、走らせる、と7回のツール呼び出しで進めました。Sonnet 5.5は平均3.3〜5.1回(合計79回)で、同じ条件の1回目は、最初のコマンドで3つのファイルをまとめて読み、2つ目のコマンドで修正・テスト追加・実行をまとめて終えています。low と medium の18回のうち16回が、この2コマンドでした。発表が挙げる、ツール呼び出しをまとめて手順を減らす動き[1]と同じです。
単価が同じなので、費用の差は、使ったトークンの種類ごとに分けて見られます。Claude Codeの既定の medium で、1回あたり$0.090下がった分の内訳は、往復ごとのキャッシュ読み込みが64%、起動時のキャッシュ書き込みが25%、出力が11%でした。書き込みが減ったのは、Claude Codeが最初に送る入力(指示とツールの説明)が、Sonnet 5で約7.1万トークン、Sonnet 5.5で約5.8万トークンと短かったためです(どちらも実行ごとのばらつきは10トークン以内)。
Sonnet 5.5の medium でも、費用の78%が起動時のキャッシュ書き込みで、出力は5%でした。出力単価だけを見て費用を見積もると、モデルによる費用の差も、effortを変える効果も読み違えます。
effortの効き方も変わっていました。Sonnet 5では、low から high まで費用が$0.275〜$0.291でほぼ動かず、所要時間だけが high で伸びました(medium の27.3秒が、high で36.4秒)。Sonnet 5.5では、medium から high に上げると費用が12%、所要時間が45%増えます($0.186→$0.208、11.4秒→16.6秒)。公式が「effortの目盛りは作り直された。Sonnet 5の設定を持ち越さず、測り直すように」と注意している[6][7]とおり、同じ名前の設定でも効き方が違います。
作業の量は減っていません。修正は54回すべて periods.py の1行の書き換えで、テストに足した確認(assert)は、Sonnet 5.5が27回とも4〜6件、Sonnet 5は1〜8件でした。テストを実行したのも54回すべてです。「3行以内で報告して」という指示を守れたのは、Sonnet 5.5が27回中26回、Sonnet 5が27回中18回でした(空行を除いた行数)。発表に載った顧客の数字(出力14%減・合計12%減など)はこの課題の差より小さく、作業の種類で差が変わることが分かります。
測ったのは数十秒で終わる小さな課題1種類で、各条件9回です。数時間かかる長い作業や、xhigh・max、文書づくりのような作業は測っていません。長い作業では、自社の作業で測り直してください。
05 エラーを出さずに変わること
費用とは別に、乗り換えただけで振る舞いが変わる点が公式に挙がっています[6][7][9]。どれもリクエストは成功するので、エラーでは気づけません。なお、AIの返答は、文章(text)や、AIが考えたことを入れる別枠(thinking ブロック)などの部品に分かれて届きます。
| 変わること | 何が起きるか | 公式の対処 |
|---|---|---|
| effortの目盛りが作り直された | 同じ high でも、考える量がSonnet 5とは違う。設定を持ち越すと、費用も待ち時間も想定とずれる | 持ち越さず、自社の作業で段階ごとに測り直す(APIの既定は high、Claude Codeとアプリの既定は medium) |
| ツールの合間の途中経過 | 1〜2文より長い経過報告が text でなく thinking ブロックで届く。既定では中身が空なので、途中経過を表示している画面が黙る | thinking.display を updates(ベータ)か summarized にする。between_tools にすると text で戻る |
| 頼んでいない追加 | テスト・文書・小さなファイルを、頼まなくても足しやすい(effortが高いほど多い) | システムプロンプトに「頼まれたことが終わったら止まり、足したいものは最後に提案するだけ」と書く |
| 低いeffortでの途中確認と検証の省略 | low と medium の長い作業では、途中で確認を挟みやすい。low では、テストなどを走らせずに「終わった」と報告することがある | effortを上げるか、「実行できる変更は、実際にテストやビルドを走らせてから報告する」と書く |
| 思考ブロックがアカウントに紐づく | Sonnet 5.5の思考ブロックは、作ったアカウント(と連携したアカウント)でしか読まれない。別のアカウントから送ると、APIは黙って捨て、リクエストは成功し、捨てた分は課金されない | 会話を別のアカウントへ移す使い方(Claude Codeでセッションの途中にアカウントを切り替える場合を含む)では、前の思考が引き継がれない前提にする |
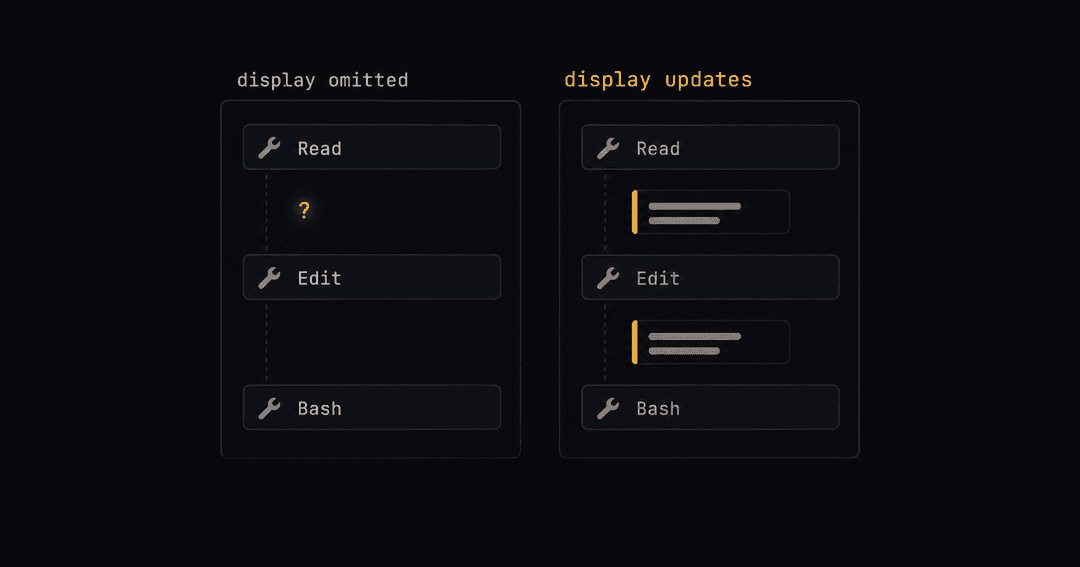
途中経過の変化は、今回の実測にも出ていました。ツールを呼ぶ直前に、通常の文章(text)として届いた途中経過は、Sonnet 5で27回の実行に29回、Sonnet 5.5で2回でした(ツール呼び出しの総数が219回と79回なので、1回あたりでは13%と3%)。Sonnet 5.5では、同じ位置に中身のある thinking ブロックが8回、中身の空の thinking ブロックが22回届いています(Sonnet 5は中身ありが0回、空が64回)。APIで自社の画面を作っている場合、表示の設定を直さないと、途中経過はこのままでは空白になります。
この調査でも「黙る」ことは起きました。Claude Codeのデスクトップ版でこの記事の調査を進めているあいだ、ユーザーに文章を返さないままツール呼び出しが続くたびに、公式ガイドの例文と同じ英文が会話に差し込まれました。
The user hasn't heard from you in a while — say in a few words what you're doing, then continue.
Claude Codeのセッション記録より(silent_turn_reminder)。公式ガイド「Prompting Claude Sonnet 5.5」の例文と同一
差し込まれたのは、この記事を組み立てるまでに4回で、直前のツール呼び出しは5〜11回続いていました。公式ガイドが示す「ハーネス(AIを動かす側のプログラム)が催促を差し込む」[7]作りが、製品にそのまま入っています。
06 400で止まる変更と、別のモデルに回される依頼
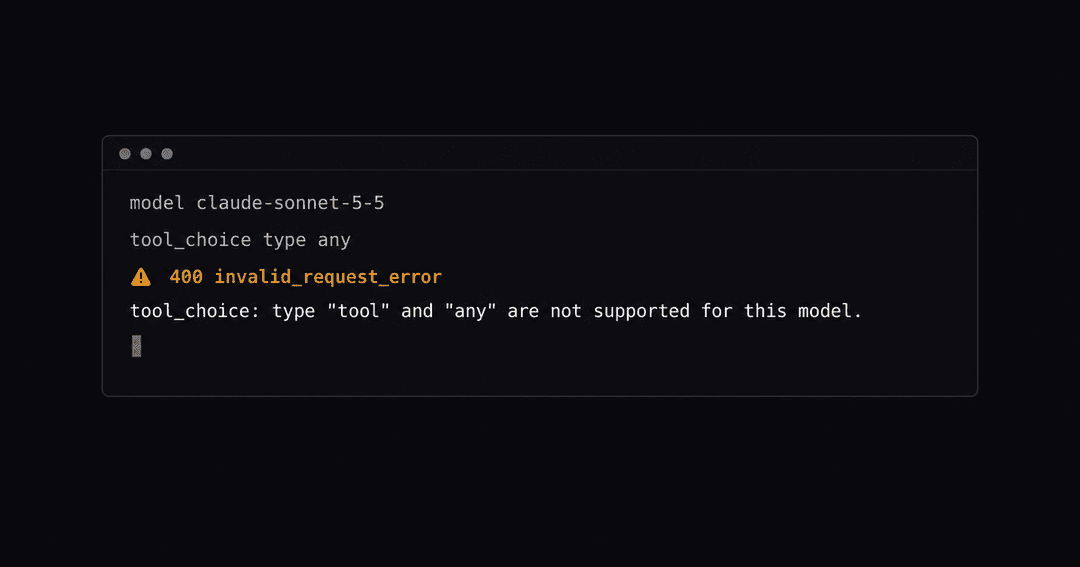
こちらはエラーで止まるので、気づくことはできます。Sonnet 5で動いていたコードが400を返す変更は5つです[2][6]。
| 400になる書き方 | 代わりの書き方 |
|---|---|
思考をOFFにする(thinking: disabled) | thinking: {"type": "between_tools"} にする。high 以下のeffortだけで、xhigh・max では400 |
ツールを強制する(tool_choice の any と tool) | auto + strict tool use か構造化出力にし、使ってほしい場面をプロンプトに書く |
| 思考ブロックを残したまま、過去の発言・指示・ツールを書き換える(2026年8月31日以降に作ったアカウント) | 会話を追記だけにする。指示やツールの変更は、会話途中のシステムメッセージで行う |
旧来の画面操作ツール computer_20251124(Claude APIとGoogle Cloud) | computer_toolset_20260801 に移る。Amazon Bedrockでは旧来のままでよい |
| アドバイザーツールの相手にOpus 4.8・Opus 4.7・Sonnet 5を指定する | Opus 5.5・Opus 5・Fable 5.1・Mythos 5.1などか、Sonnet 5.5自身を指定する |
 関連記事 | 同じ変更を先に入れたモデルClaude Fable 5.1 が来た ──乗り換えで止まる3つの変更と、エラーが出ないまま変わる7つの挙動
→
もう1つは安全策です。Sonnet 5.5はサイバーセキュリティの能力がSonnet 5から大きく上がったため、Sonnetとして初めて、上位モデルと同じ種類のサイバー安全策と切り替えの仕組みを付けて公開されました[1][8]。
- 攻撃寄りのサイバーセキュリティ作業(脆弱性を突くコードの作成、侵入テストなど)と、最先端のLLM開発に関わる一部の作業は、Sonnet 5に回されます。ふだんの開発や、ソースコードの脆弱性を見つけて直す範囲は対象外です。Claudeのアプリでは自動で切り替わり、そのチャットのモデル選択はSonnet 5に残ります[8]
- 生物学の危険な依頼と、AIの思考過程をそのまま書き出させる依頼は、Sonnet 5に回されず、その場で止まります。思考過程の書き出しを求める指示は
reasoning_extractionの拒否の対象で、「なぜそうしたの?」と理由を聞く程度は対象外です[8] - APIでは、拒否はエラーでなくHTTP 200で返ります。
stop_reasonがrefusalになり、stop_detailsに分野(cyber・bio・frontier_llm・reasoning_extraction・general_harms)が入ります。ステータスコードだけ見ている処理は、拒否を成功として扱います。Sonnet 5にやり直させる設定(server-side fallback・ベータ)はありますが、対象はcyberとfrontier_llmだけです[6]
安全面では、Anthropic社内の約1,850の場面での監査で、多くの項目でSonnet 5と同等かそれ以上の成績でした。閉じ込められた環境から抜け出そうとする頻度は、Opus 5.5に近いとされています。一方で「見つけていない傾向があるかもしれない」とも書いており、評価の結果をそのまま実環境に当てはめられるとは言っていません[1]。
07 乗り換える前に確かめること
自社で使っているAIツールや、外注しているシステムがある場合は、モデル名を書き換える前に、担当者に次の7点を確かめてもらってください。
- Claude Codeを2.1.284以上にそろえる。古い版はSonnet 5.5を「未対応」と警告し、費用をOpus 5.5の単価で表示します
- effortを明示し、自社の作業で測り直す。APIの既定は
high、Claude Codeとアプリの既定はmediumです。今回の課題では、Sonnet 5.5のhighはmediumより費用が12%、所要時間が45%増えました - コードの中から
thinking: disabled・tool_choice: any / tool・computer_20251124を探す。残っていると400で止まります - 途中経過を出している画面は、
thinking.displayかbetween_toolsを設定する。設定しないと、ツールを呼ぶ合間の表示がエラーなしで消えます - 会話を追記だけにする。2026年8月31日以降に作ったアカウントは、思考ブロックを残したまま履歴を書き換えると400になります
- 拒否(
stop_reason: refusal)を扱う処理を入れる。HTTP 200で返るので、ステータスコードでは拾えません。サイバー系の作業がSonnet 5に回る前提で、返ってきたモデル名も確認します - 費用は、キャッシュを含めた実費で比べる。出力単価だけでは見積もりがずれます。今回の課題では、Sonnet 5.5の
mediumでも費用の78%が起動時のキャッシュ書き込みでした
| 発表の説明 | CAGの実測・docsで分かったこと | |
|---|---|---|
| 安さ | ほとんどの作業で最大30%安い | effortをそろえた平均で27〜36%安い(周別では20〜44%・小さな課題・各9回) |
| 速さ | 出力が30%以上速い | 所要時間は平均で55〜58%短い(周別では47〜66%。出力の速さそのものは測っていない) |
| 性能 | Sonnet 5から明確に良くなった。Opus 5.5は複雑な仕事で引き続き強い | 8項目すべてでSonnet 5を上回り、Opus 5.5が上なのは7項目 |
| 移行 | Sonnet 5のプロンプトはそのままで動く | 400が5か所、エラーなしの変化が複数。古いClaude Codeは費用が倍近く見える |
この記事の調査と執筆は、Sonnet 5.5で動くClaude Codeで行いました(実測は、その中から両モデルを指定して走らせています)。今回の課題でいちばん大きかった差は、往復の回数と所要時間でした(正解は54回すべて)。
同じ単価で安く速くなった理由は、往復の少なさ。乗り換えの手間は、画面に出ない部分に残る。
AIの切り替えや費用の見直しを相談したい方へ
電脳技巧集団(AI職人ギルド)は、AI駆動で業務システムをつくっています。どのモデルをどの設定で使うか、自社の作業で測って決めるところから相談できます。お問い合わせはこちら
出典・注記
- Anthropic「Introducing Claude Sonnet 5.5」2026年9月28日。https://www.anthropic.com/claude-sonnet-5-5
- Claude Platform Docs「Claude Sonnet 5.5」(2026年9月29日閲覧)。https://platform.claude.com/docs/en/models/sonnet-5-5/overview
- Claude Platform Docs「Claude Sonnet 5」(2026年9月29日閲覧)。https://platform.claude.com/docs/en/models/sonnet-5/overview
- Claude Platform Docs「Pricing」および「Claude Platform release notes」2026年8月10日・9月28日(2026年9月29日閲覧)。https://platform.claude.com/docs/en/about-claude/pricing
- Claude Code CHANGELOG 2.1.284(2026年9月29日閲覧)。https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Claude Platform Docs「What's new in Claude Sonnet 5.5」(2026年9月29日閲覧)。https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Claude Platform Docs「Migrating to Claude Sonnet 5.5」「Prompting Claude Sonnet 5.5」(2026年9月29日閲覧)。https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- Claude Help Center「Why Claude switched models in your conversation with Sonnet 5.5」(2026年9月29日閲覧)。https://support.claude.com/en/articles/17161993-why-claude-switched-models-in-your-conversation-with-sonnet-5-5
- Claude Help Center「Preserved thinking: changing how the Messages API handles thinking blocks to protect against distillation」(2026年9月29日閲覧)。https://support.claude.com/en/articles/16761192-preserved-thinking-changing-how-the-messages-api-handles-thinking-blocks-to-protect-against-distillation
- CAGによる実測(2026年9月29日)。Claude Code 2.1.284の非対話モードで、ユーザー設定・フック・MCPを読み込まない状態にそろえ、モデル(
claude-sonnet-5/claude-sonnet-5-5)とeffortだけを変えて各9回、計54回実行しました(3周に分け、2周目だけ実行順を逆にしています)。費用はClaude Codeが報告する定価換算の値で、1時間のキャッシュ書き込み単価で計算し直すと一致しました。54回の合計は約12.86ドル。課題はテストを含めて約70行のPythonコード1種類で、長時間の作業やxhigh・max、文書づくりは測っていません。Claude Codeの版による費用表示の違いは、2.1.283と2.1.284で同じ呼び出し(Reply with exactly: OK)を1回ずつ実行して確かめました。ベンチマーク表と顧客の声はAnthropicの発表からの引用で、CAGの検証ではありません。